概览
操作流程
设置连接和读取超时
显式配置 timeout,并捕获对应的 Requests 异常。
验证应用任务时限
测试本地延迟端点,并单独管理整个任务的时间限制。
使用 Python Requests 时,请显式设置超时,例如 requests.get(url, timeout=(3, 15))。这个元组分别控制连接建立和等待响应数据的时间。Requests 没有默认超时,这项设置也不是整个采集任务的完成期限。
将超时设置与响应状态检查、少量明确的错误分类结合使用,可以让工作进程在遇到等待问题时结束本次操作,并报告下一步应该检查网络、代理配置还是目标服务。
分别设置连接和读取时限
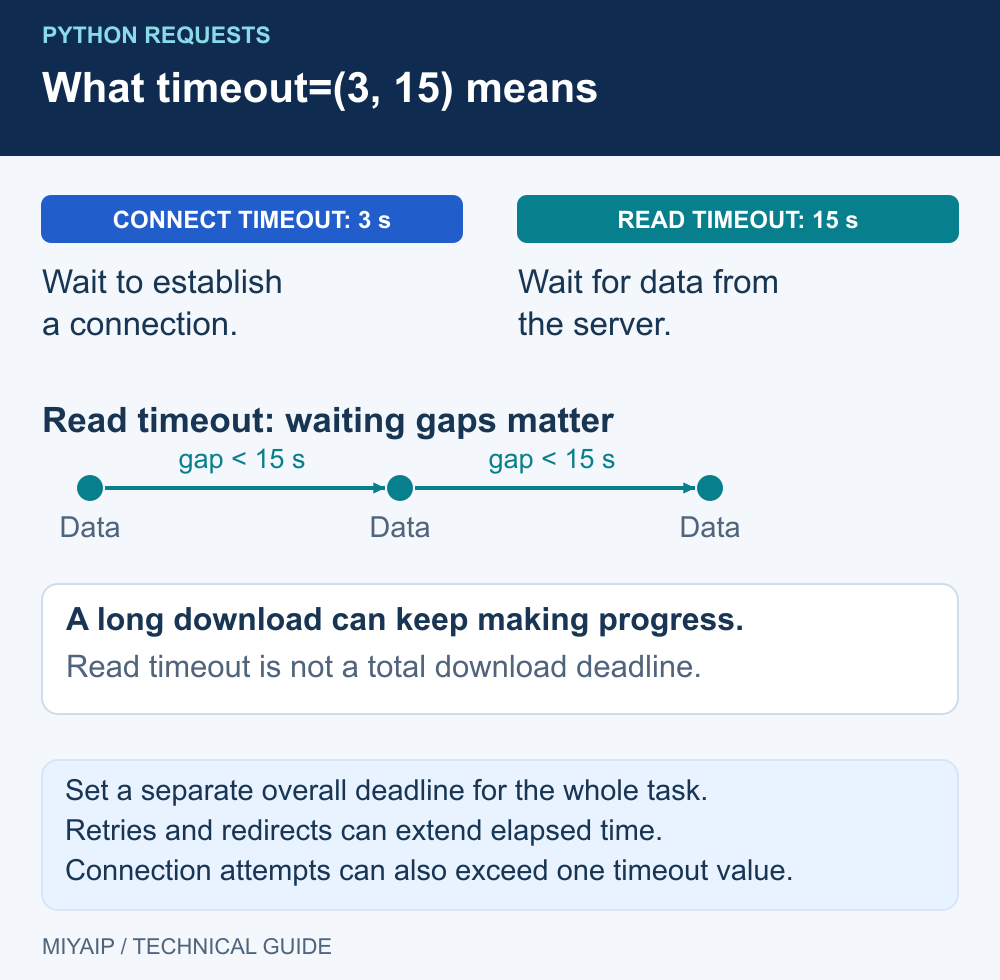
Requests 分别控制连接等待和读取期间的数据等待;元组中的两个值并不构成整个任务的实际时间上限。
设置 | 含义 | 适用示例 |
|---|---|---|
| 连接超时和读取超时使用相同值 | 作为简单的初始配置 |
| 分别设置连接和读取时限 | 尽早结束无法建立的连接,同时允许响应等待更久 |
| 不对本次操作施加 Requests 超时 | 无人值守的工作进程应避免这样设置,除非其他机制负责控制运行时长 |
读取超时关注的是等待响应数据期间没有数据到达的时间,不是最大响应大小或整个下载的总时长。重试、尝试多个地址和重定向都会进一步增加耗时。3 秒、15 秒等只是示例设置值。Requests 超时文档介绍了这些语义。
发送一次请求,并报告有用的结果
使用 python -m pip install requests 安装 Requests。下面的示例只发起一次只读请求,不会自动重试。
import requests

url = "https://example.com/"
try:
    response = requests.get(url, timeout=(3, 15))
    response.raise_for_status()
    print({"outcome": "ok", "status": response.status_code})
except requests.exceptions.ConnectTimeout:
    print({"outcome": "connect_timeout"})
except requests.exceptions.ReadTimeout:
    print({"outcome": "read_timeout"})
except requests.exceptions.ProxyError:
    print({"outcome": "proxy_error"})
except requests.exceptions.SSLError:
    print({"outcome": "tls_error"})
except requests.exceptions.HTTPError as error:
    print({"outcome": "http_error", "status": error.response.status_code})
except requests.exceptions.RequestException:
    print({"outcome": "request_error"})
特定异常的处理分支放在通用异常之前。代理协商问题不保证会表现为 Timeout;读取流式响应期间发生的失败,也可能被包装为其他异常。最后的通用分支避免把请求失败误认为成功但没有内容的结果。这里刻意不打印原始异常字符串,因为其中可能包含连接信息。
区分代理配置问题与响应等待
如果应用使用 MIYAIP,请从连接设置中复制协议、端点和凭据,并参考 Requests 代理示例。比较不同线路时,保持目标和超时设置相同。对于原生连接,应先确认所需网络路径可用,再考虑增加读取超时是否有帮助。
结果 | 值得优先检查的内容 |
|---|---|
| 端点可达性、DNS、端口,以及当前运行环境到端点的线路 |
| 目标响应时间、响应大小,以及连接建立后线路是否停滞 |
| 代理协议、凭据、CONNECT 响应,以及从环境继承的配置 |
| 当前 Python 环境使用的证书链、主机名和信任存储 |
| 实际响应状态与目标服务说明,包括限流响应头 |
Requests 可以读取环境中的代理设置。笔记本环境、容器和定时工作进程可能继承不同变量。比较当前生效的配置时,不要暴露密码。对于需要隔离环境的本地演示,设置 Session.trust_env=False 可以避免继承代理及其他环境配置;不要不加判断地将该设置应用到依赖这些配置的部署环境。
请求超时不等于整个任务的期限
对于处理多个 URL 的任务,还需要分别控制尝试次数、重试之间的等待时间,以及任务的整体运行时长。线程 future 的等待超时只让调用方停止等待,不会自动取消工作线程中的 Requests 操作。如果任务必须在严格的实际时间上限内停止,应为执行系统提供明确的取消或终止进程机制。
可以使用随附的本地演示服务观察读取超时,不必依赖外部慢速网站。启动 network_demo.py 后运行:
import requests

with requests.Session() as session:
    session.trust_env = False
    try:
        session.get("http://127.0.0.1:8766/slow", timeout=(1, 0.2))
    except requests.exceptions.ReadTimeout:
        print("read_timeout")
演示路由会等待两秒才发送响应,因此 0.2 秒的读取等待会到期。将读取值提高到 3 秒,就能让本地响应完成。这个示例展示了代码面对延迟响应时的行为。
常见问题
常见问题
Requests Session 会为所有请求提供默认超时吗?
单独创建 Session 不会增加默认超时。需要在每次调用中传入 timeout,或使用统一提供该参数的包装函数。
十秒超时能保证整个调用在十秒内结束吗?
不能。连接和读取时限与总经过时间并不相同。还应考虑重定向、地址尝试、响应流读取,以及外层工作流程中的重试。
所有超时都应该重试吗?
不应该。先检查操作是否可以安全重复,以及原因是否可能是暂时性的。MIYAIP 网页采集示例提供了限制尝试次数和延后处理 Retry-After 的采集流程。
扩大任务规模前,先验证线路
先完成一次有效请求,确认结果,再根据实际工作负载选择时限。
下一步
运行本地演示
下载 network_demo.py,或将以下完整代码保存为同名文件。使用 Python 3 运行 python network_demo.py。服务仅监听 127.0.0.1:8766,使用完按 Ctrl+C 退出。
"""Local HTTP demonstration. No external requests, credentials or MIYAIP service calls."""
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from urllib.parse import urlsplit
import json
import time


class DemoHandler(BaseHTTPRequestHandler):
    def log_message(self, *_):
        pass

    def reply(self, code, body=b"", headers=None):
        self.send_response(code)
        for key, value in (headers or {}).items():
            self.send_header(key, value)
        self.send_header("Content-Length", str(len(body)))
        try:
            self.end_headers()
            self.wfile.write(body)
        except (BrokenPipeError, ConnectionResetError, ConnectionAbortedError):
            pass

    def do_CONNECT(self):
        self.reply(407, headers={"Proxy-Authenticate": 'Basic realm="local-demo"'})

    def do_GET(self):
        path = urlsplit(self.path).path
        if path == "/redirect":
            return self.reply(302, headers={"Location": "/headers"})
        if path == "/loop":
            return self.reply(302, headers={"Location": "/loop"})
        if path == "/slow":
            time.sleep(2)
        if path in {"/headers", "/slow"}:
            payload = {"method": self.command, "headers": dict(self.headers)}
            return self.reply(200, json.dumps(payload, indent=2).encode(),
                              {"Content-Type": "application/json"})
        self.reply(404, b"Use /headers, /redirect, /loop or /slow")

    def do_POST(self):
        body = self.rfile.read(int(self.headers.get("Content-Length", "0")))
        if urlsplit(self.path).path == "/redirect307":
            return self.reply(307, headers={"Location": "/headers"})
        if urlsplit(self.path).path == "/redirect302":
            return self.reply(302, headers={"Location": "/headers"})
        payload = {"method": self.command, "headers": dict(self.headers),
                   "body": body.decode("utf-8", errors="replace")}
        self.reply(200, json.dumps(payload, indent=2).encode(),
                   {"Content-Type": "application/json"})


if __name__ == "__main__":
    print("Local demonstration: http://127.0.0.1:8766 (Ctrl+C to stop)", flush=True)
    ThreadingHTTPServer(("127.0.0.1", 8766), DemoHandler).serve_forever()