
使用示例测试表达式
示例包含三张虚构商品卡片。表达式 //article[@class="product"]/h2/text() 返回 Desk Lamp、Travel Mug 和 Notebook。每条结果都包含其在解析树中的位置。修改输入会清除旧结果,确保显示的内容来自上一次已完成的查询。
商品名称
//article[@class="product"]/h2/text()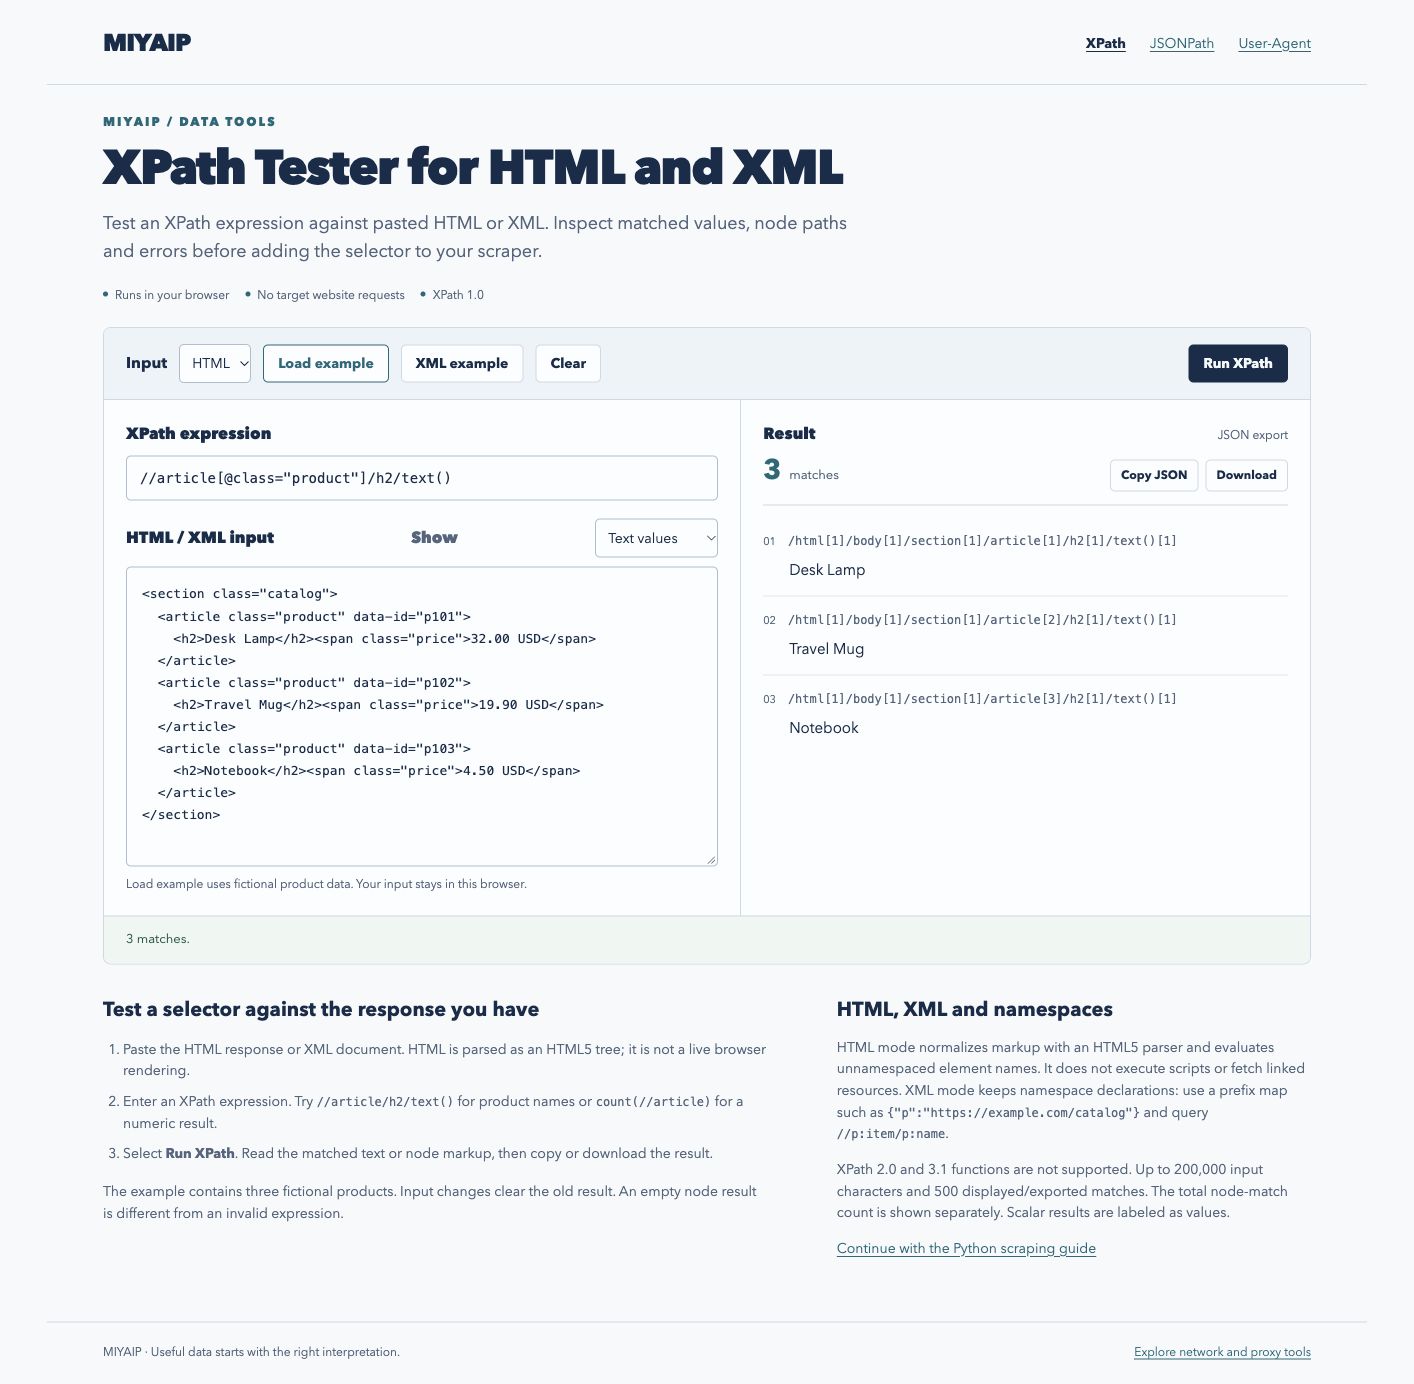
MIYAIP TOOLS
粘贴 HTML 响应或 XML 文档,输入 XPath 表达式,在加入采集脚本前检查选中的值。查询在当前浏览器中运行,结果可复制或下载为 JSON。
输入仅在当前浏览器内处理。
XPath 1.0 · HTML/XML:200,000 字符 · 表达式:2,000 字符 · 最多展示 500 条
请粘贴输入,或载入虚构示例。
示例包含三张虚构商品卡片。表达式 //article[@class="product"]/h2/text() 返回 Desk Lamp、Travel Mug 和 Notebook。每条结果都包含其在解析树中的位置。修改输入会清除旧结果,确保显示的内容来自上一次已完成的查询。
//article[@class="product"]/h2/text()HTML 模式将粘贴的标记解析为 HTML5 树,补齐隐含元素等文档结构,并使用不带命名空间的元素名称求值。脚本不会执行,也不会请求外链资源。排查基于响应的采集脚本时,请粘贴实际响应正文;浏览器中的实时 DOM 可能包含 JavaScript 后续添加的元素。
XML 模式保留命名空间声明。XML 示例的默认命名空间为 https://example.com/catalog,可映射到查询前缀:
{"p":"https://example.com/catalog"}
然后执行 //p:item/p:name/text()。前缀是查询中使用的本地标签,命名空间 URI 才是元素的标识。此工具不接受 DTD 和 ENTITY 声明。
| 表达式 | HTML 示例中的结果 |
|---|---|
//article/h2/text() |
三个商品名称 |
//article/@data-id |
三个 ID 属性 |
count(//article) |
一个数值:3 |
boolean(//article[@data-id='p999']) |
一个布尔值:false |
//article/h3 |
表达式有效,零条匹配 |
需要检查选中的元素及属性时,选择「节点标记」;需要提取内容时,选择「文本值」。数值、字符串和布尔表达式返回标量值,而不是节点匹配数量。显示的节点位置描述解析后的树,将位置重用为查询时,需要调整命名空间前缀。
工作台使用浏览器的 XPath 1.0 求值接口,不支持 XPath 2.0 和 3.1 函数。HTML/XML 输入最多 200,000 个字符,表达式最多 2,000 个字符。结果视图和 JSON 导出最多包含 500 条节点匹配,匹配总数单独显示。HTML 树还限制为 20,000 个节点和 64 层嵌套。
如果选择器在这里可用、在其他库中却失败,请核对库接收的文档、命名空间映射和 XPath 版本是否相同。例如 ElementTree 只支持简化的 XPath 语法,与完整的 XPath 1.0 引擎不同。
FAQ
不会。工具对你粘贴的文档求值。获取正确的响应、渲染 JavaScript 和处理分页,仍需在采集流程中分别完成。
检查文档的默认命名空间,并在命名空间映射中绑定查询前缀。不带前缀的元素名称不会自动匹配 XML 默认命名空间中的元素。
这表示所提供的文档包含该匹配值。获取源数据时,还应检查原始响应状态、内容类型和预期记录。MIYAIP 的 Python 网页采集教程 介绍完整的获取与提取流程。
MIYAIP
创建账号管理代理产品,或先查看动态住宅代理的流量定价。