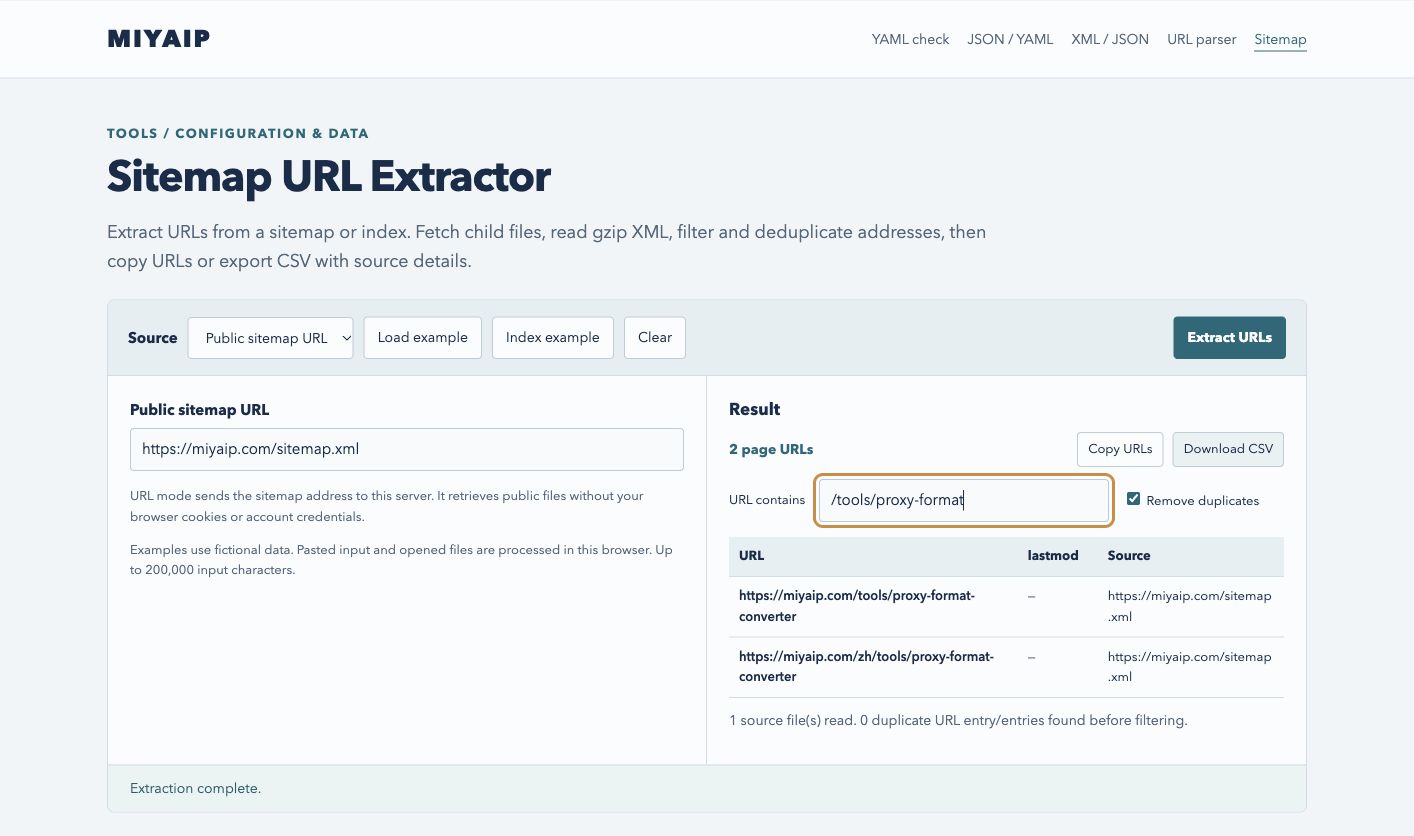
区分页面地址与子 Sitemap 地址
| Sitemap 输入 | 提取结果 |
|---|---|
| 粘贴或打开 <urlset> | 从 <url><loc> 提取页面 URL |
| 粘贴或打开 <sitemapindex> | 子 Sitemap 地址 |
| 指向索引的公开 URL | 从读取的子文件中提取页面 URL |
粘贴的 XML 和打开的 UTF-8 文件均在当前浏览器内处理。「索引示例」使用浏览器内置的虚构文件。选择「公开 Sitemap URL」时,工作台会把地址发送给服务,由服务独立连接公开文件并跟随索引引用,浏览器会话信息保留在本地。
提取器支持标准 Sitemap 命名空间及无命名空间的文档。它读取 Sitemap 条目下直接包含的 loc 和 lastmod 元素,跳过图片、视频和新闻扩展的地址。解析器会拒绝 DTD 和 ENTITY 声明。