BeautifulSoup find_all() 从 HTML 树返回匹配元素。使用标签、属性、类名或文本缩小搜索,再在各条匹配记录内提取字段。它只解析传入的 HTML,不抓取网站,也不运行 JavaScript。
调试时,与其不断尝试新选择器,更应先确认:这份 HTML 是否包含预期记录,哪个元素代表这条记录?
流程概览
1. 从已知的小型 HTML 样本开始
执行
python -m pip install beautifulsoup4 requests安装依赖,再运行以下不访问网站的示例:2. 选择正确的过滤条件
使用
class_是因为class是 Python 保留字。对于data-id等属性,使用attrs字典,不要尝试将 HTML 属性写成 Python 关键字。3. 理解多个类名
class_="product"匹配包含该类名的元素,也包括class="product featured"。4. 保持字段与记录对应
在每张卡片内提取,可防止某条缺失价格导致后面的价格错配到其他商品。确定币种和解析规则前,保留原始价格文本。
5. 明确处理文本和嵌套
使用
string过滤文本;单独使用时返回匹配的文本节点:6. 更换库前先排查空结果
没有匹配项时,
find_all()返回空集合,find()返回None。访问文本或属性前先处理这些情况。
1. 从已知的小型 HTML 样本开始
执行 python -m pip install beautifulsoup4 requests 安装依赖,再运行以下不访问网站的示例:
from bs4 import BeautifulSoup

html = """
<main>
  <article class="product featured" data-id="p1">
    <h2>Travel Mug</h2><span class="price">$19.90</span>
    <a href="/item/p1">Details</a>
  </article>
  <article class="product" data-id="p2">
    <h2>Desk Lamp</h2><span class="price">$32.00</span>
    <a href="/item/p2">Details</a>
  </article>
</main>
"""
soup = BeautifulSoup(html, "html.parser")
cards = soup.find_all("article", class_="product")
print([card["data-id"] for card in cards])
# ['p1', 'p2']
结果是 Tag 对象的集合。应从各个标签提取文本或属性,不要把整个集合当作一个元素。
2. 选择正确的过滤条件
需求 | 示例 | 本样本结果 |
|---|---|---|
全部商品容器 |
| 两个 article 标签 |
指定标识符 |
| 第一个 article |
具有 href 的链接 |
| 两个链接 |
多种候选标签 |
| 标题和链接 |
仅第一个 article |
| 包含一个 article 的集合 |
使用 class_ 是因为 class 是 Python 保留字。对于 data-id 等属性,使用 attrs 字典,不要尝试将 HTML 属性写成 Python 关键字。
Beautiful Soup 搜索文档定义了过滤条件及其组合。排查不规范 HTML 时保持解析器一致,不同解析器修复错误标记的方式可能不同。
3. 理解多个类名
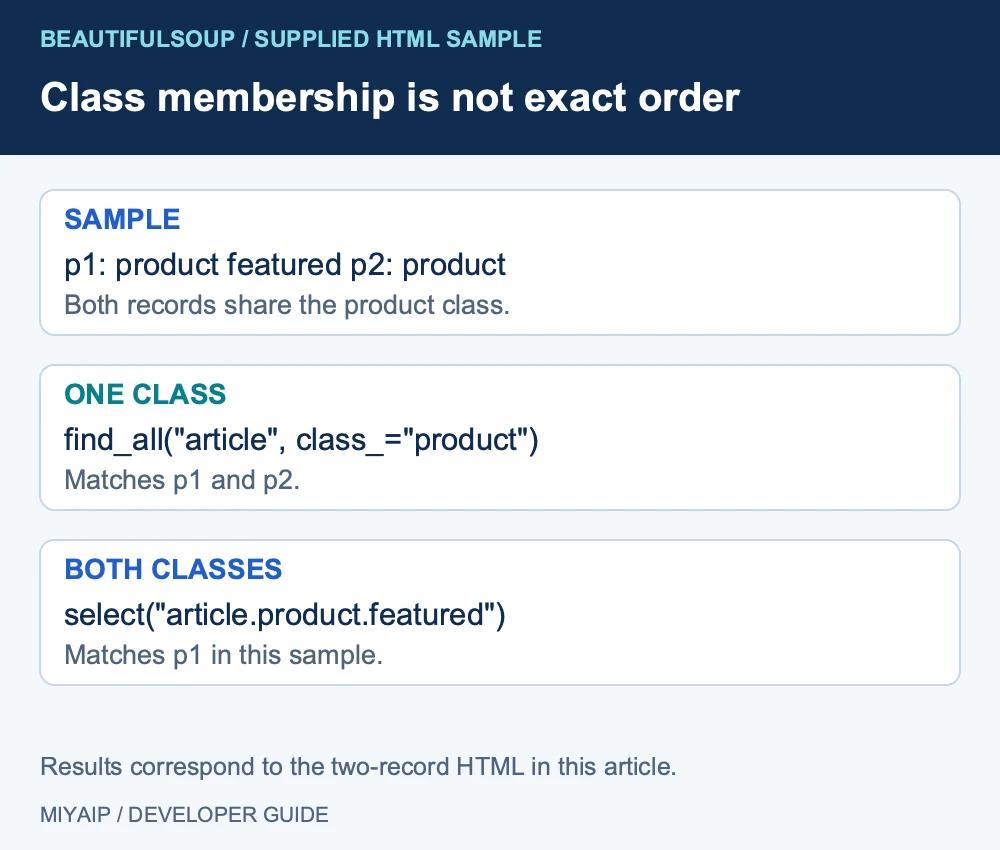
class_="product" 匹配包含该类名的元素,也包括 class="product featured"。
要求元素同时具备两个类名时,可直接用 CSS 选择器表达:
featured_products = soup.select("article.product.featured")
print([card["data-id"] for card in featured_products])
# ['p1']
向 find_all() 传入类名列表,不代表所有类名必须同时存在。真实需求是同时包含两个类名时,不要依赖多类名属性字符串的精确排列顺序。
4. 保持字段与记录对应
rows = []
for card in soup.find_all("article", class_="product"):
    title = card.find("h2")
    price = card.find("span", class_="price")
    if title is None or price is None:
        raise ValueError("Product is missing a required field")
    rows.append({
        "id": card.get("data-id"),
        "name": title.get_text(" ", strip=True),
        "price_text": price.get_text(strip=True),
    })
print(rows)
在每张卡片内提取,可防止某条缺失价格导致后面的价格错配到其他商品。确定币种和解析规则前,保留原始价格文本。
5. 明确处理文本和嵌套
使用 string 过滤文本;单独使用时返回匹配的文本节点:
import re
matches = soup.find_all(string=re.compile(r"Mug|Lamp"))
print([str(value) for value in matches])标签含多个子节点时,.string 可能为 None。标题中包含嵌套标记时,先获取标题元素,再使用 get_text() 读取合并文本。
搜索通常包含后代节点。只搜索直接子节点时,在 find_all() 设置 recursive=False。应对正确父元素调用;所需标签位于深层时,对整份文档调用可能返回空结果。
6. 更换库前先排查空结果
- 检查 HTTP 状态和程序实际收到的响应正文。
- 在正文中搜索已知记录名称或属性。
- 针对这份正文确认容器和选择器,不要只参考浏览器渲染后的 DOM。
- 检查鉴权、重定向或客户端渲染是否解释了差异。
没有匹配项时,find_all() 返回空集合,find() 返回 None。访问文本或属性前先处理这些情况。
有关获取、分页和导出,请继续阅读 Python 采集指南。请求需要其他网络路径时,MIYAIP 代理套餐可支持 HTTP 客户端,但不会改变 BeautifulSoup 的 HTML 匹配方式。
常见问题
find_all() 和 select() 有什么区别?
两者都定位元素,但接受不同查询形式。标签、属性或可调用过滤适合 find_all();CSS 更能清楚表达结构时使用 select()。
为什么对结果调用 .text 会失败?
集合包含标签,但集合本身不是标签。请遍历集合;明确只需要首个匹配项时使用 find()。
limit=10 能采集前十页吗?
不能。它限制当前已解析 HTML 树中的匹配元素数量,请求与分页属于独立操作。
先验证已知 HTML 样本,再在解析器周围增加数据获取、有上限的分页与输出检查。