

Python 网页抓取,就是获取网页或在浏览器中渲染页面,再把需要的字段提取成可用的数据记录。数据已经存在于 HTML 中时,可以从 Requests 和 Beautiful Soup 开始;需要持续抓取大量页面、管理链接发现与数据处理时,再引入 Scrapy;数据依赖 JavaScript 或浏览器操作时,使用 Playwright。
选择技术栈时,先回答三个问题:数据出现在哪里、采集是否需要交互,以及要持续采集多少数据?本文从可以在本地复现的练习出发,逐步介绍分页、动态内容、错误处理、存储和网络路由。阅读时需要具备基本 Python 知识;将示例迁移到真实网站前,应确认具备相应访问许可。
先选对工具
场景 | 建议起点 |
|---|---|
静态 HTML,页面数量较少 | Requests + Beautiful Soup |
需要 XPath 或专门的 HTML/XML 解析 | lxml |
多页、周期性且需要组织结构的抓取 | Scrapy |
JavaScript 渲染的数据 | Playwright |
已有浏览器自动化基础设施 | 按集成需求选择 Playwright 或 Selenium |
需要地域路由或稳定的出口身份 | 存在明确网络需求时再评估代理 |
工具选择决策图提供的是起点,不限制工具之间的组合。浏览器能够向解析器提供 HTML,爬虫框架也可以统一管理一组数据提取任务。应根据每个组件实际负责的工作进行选择。
Python 网页抓取的基本流程
常见流程是:URL → HTTP 响应或渲染后的 DOM → CSS/XPath 定位 → 结构化记录 → 清洗与校验 → CSV、JSON 或数据库。商品名称、价格、SKU、库存状态、文章标题和表格单元格都可以作为提取字段。请求成功只是第一步,最后得到的数据还必须满足实际使用要求。
网页爬行和数据抓取解决的问题不同:爬行负责发现并访问链接,例如“首页 → 分类页 → 商品页”;抓取负责从页面中提取指定字段。小脚本可以同时完成两者,项目变大后,将链接发现、字段提取和数据处理分开会更容易维护。
Python 的生态中包含 HTTP 客户端、解析器、爬虫框架、浏览器自动化和数据处理工具。但它并非在所有场景下都优于 R。如果后续工作本来就是 R 统计分析流程,继续使用 R 可能更方便;如果应用和自动化管道以 Python 为主,Python 通常更容易衔接。语言选择应服务于整个任务。
常用 Python 抓取库及其分工
工具 | 主要职责 | 执行页面 JavaScript? | 抓取任务组织能力 |
|---|---|---|---|
Requests | HTTP 客户端 | 否 | 自行编写请求逻辑 |
Beautiful Soup | HTML/XML 解析接口 | 否 | 不内置爬虫 |
lxml | HTML/XML 解析与 XPath | 否 | 不内置爬虫 |
Scrapy | 爬行与数据提取框架 | 本身不执行 | 调度、选择器、管道和导出 |
Selenium | 浏览器自动化 | 是 | 需要组织抓取任务 |
Playwright | 浏览器自动化 | 是 | 需要组织抓取任务 |
Requests + Beautiful Soup
这组工具能清晰地分开“获取页面”和“解析页面”:Requests 提供响应状态处理和超时配置,Beautiful Soup 用于定位元素、提取文本。静态文章、目录、公开表格、文档站和简单列表页都适合从这里入门。两者都不会执行页面 JavaScript。具体用法见 Requests 入门文档与 Beautiful Soup 文档。
lxml
当提取逻辑适合 XPath,或需要 lxml 的 HTML/XML 树接口时,可以选择 lxml。如果解析成为性能瓶颈,也可以用真实输入比较不同解析器,不能预设所有场景都会更快。lxml HTML 文档介绍了解析接口。完成后面的教程、得到 html_text 后,可以用下面的可选示例提取相同商品标题:
# Optional dependency: python -m pip install lxml
from lxml import html

tree = html.fromstring(html_text)
titles = tree.xpath("//div[@data-sku]/h2/text()")
print(titles)
Scrapy
Scrapy 通过 Spider、选择器和后续处理组件来组织请求与响应,适合从分类页发现商品链接、定期采集目录,以及跨大量页面分页。官方概览介绍了框架能力,Item Pipeline 文档说明了校验、清洗、去重和存储的处理位置。只抓取一个页面时,通常不必立刻引入整套结构。
Selenium 与 Playwright
浏览器自动化能够导航、点击、填写表单、滚动,并读取 JavaScript 执行后的 DOM。已有 Selenium 环境可以继续评估 Selenium WebDriver;Playwright Python支持 Chromium、Firefox 和 WebKit,并提供同步、异步 API。相比直接 HTTP 请求,浏览器进程会增加资源占用与生命周期管理工作。两者都不能保证自动化行为无法被识别。
用本地样例完成第一个抓取脚本
练习始终使用同一份本地 HTML,避免把 example.com 误当成真实商品目录。先创建一个空的练习文件夹,再将 Python 步骤依次放入同一个 scrape.py 文件或同一 Notebook 会话执行。提供 HTML 的终端需要保持运行,抓取脚本则在第二个终端中执行。下面的商品与价格均为教学样例。
从样例到导出的八个步骤
1. 安装入门所需的两个包
新项目可以先创建虚拟环境。以下命令将依赖安装到
python对应的解释器中。python -m pip install requests beautifulsoup42. 将样例保存为 products.html
将以下 HTML 原样保存为练习文件夹中的
products.html。第二个商品故意缺少价格,用于练习可选字段缺失的处理。<!doctype html> <html lang="en"> <meta charset="utf-8"> <title>Local product fixture</title> <h1>Example products</h1> <div class="product" data-sku="KB-01"> <h2 class="title">Mechanical Keyboard</h2> <span class="price">$89.99</span> </div> <div class="product" data-sku="MS-02"> <h2 class="title">Wireless Mouse</h2> <!-- A missing price is intentional. --> </div> </html>3. 启动仅供本机使用的练习服务
在该文件夹内打开终端并执行此命令。绑定回环地址后,这个教学服务仅供本机访问。不要在包含私密文件的目录中启动它;练习结束后按 Ctrl+C 停止。
python -m http.server 8000 --bind 127.0.0.14. 请求 HTML 并检查响应
在
scrape.py开头加入以下代码。超时元组分别设置连接、读取超时,并不是整个任务的总时限。raise_for_status()可避免把 HTTP 错误页面当作正常数据继续解析。import requests url = "http://127.0.0.1:8000/products.html" response = requests.get(url, timeout=(3, 10)) response.raise_for_status() html_text = response.text5. 检查 HTML,再选择定位规则
先检查标题,确认响应确实是预期的样例页面。HTTP 状态成功本身并不能证明拿到了正确页面。
from bs4 import BeautifulSoup soup = BeautifulSoup(html_text, "html.parser") heading = soup.select_one("h1") if heading is None: raise ValueError("Expected heading is missing") print(heading.get_text(" ", strip=True)) # Example products6. 提取记录并校验必填字段
继续添加这个解析函数。它在每个商品卡片内部查找字段,要求 SKU 和标题存在,并将缺失价格保留为
None。找不到任何商品时直接报错,避免失效选择器悄悄产生“成功但为空”的导出。from bs4 import BeautifulSoup def parse_products(html_text): soup = BeautifulSoup(html_text, "html.parser") cards = soup.select(".product") if not cards: raise ValueError("No product cards: check the page and selectors") rows = [] for card in cards: title = card.select_one(".title") price = card.select_one(".price") sku = (card.get("data-sku") or "").strip() title_text = title.get_text(" ", strip=True) if title else "" if not sku or not title_text: raise ValueError("Product is missing a required SKU or title") rows.append({ "sku": sku, "title": title_text, "price_text": price.get_text(" ", strip=True) if price else None, }) return rows results = parse_products(html_text) print(results)7. 规范化样例中的美元价格
下面的解析器只接受本练习约定的美元格式,也支持
$1,299.99。遇到其他格式时明确报错,不猜测地区格式。金额以十进制字符串保存,便于保持精度并一致序列化;缺失价格仍保留为None。import re from decimal import Decimal def parse_usd(value): if value is None: return None value = value.strip() if not re.fullmatch(r"\$?(?:[0-9]+|[0-9]{1,3}(?:,[0-9]{3})+)\.[0-9]{2}", value): raise ValueError(f"Unexpected USD price: {value!r}") return str(Decimal(value.removeprefix("$").replace(",", ""))) for row in results: row["price"] = parse_usd(row["price_text"]) row["currency"] = "USD" row["source_url"] = url8. 将同一批记录导出为 CSV 与 JSON
添加以下代码,再从练习文件夹运行
python scrape.py。应得到两条记录:KB-01 的价格为89.99,MS-02 在 JSON 中的价格为 null;CSV 将None写成空单元格。同时保留原始价格与规范化结果,方便核对。import csv import json from pathlib import Path fields = ["sku", "title", "price_text", "price", "currency", "source_url"] with open("products.csv", "w", newline="", encoding="utf-8") as f: writer = csv.DictWriter(f, fieldnames=fields) writer.writeheader() writer.writerows(results) Path("products.json").write_text( json.dumps(results, ensure_ascii=False, indent=2), encoding="utf-8" )
上面的提取逻辑使用了 Beautiful Soup 的 select、select_one 与 get_text。金额和导出处理可参考 Python 的 decimal 文档和 CSV 文档。这里刻意限定一种货币格式;实际处理国际商品目录时,需要明确货币及地区格式规则。
使用 CSS 选择器还是 XPath?
CSS 通常便于表达类名、ID、属性和后代关系;XPath 更适合描述复杂树结构关系。对于本地样例,.product .title 可以选中商品标题;使用 lxml 或 Scrapy 时,//div[@data-sku]/h2 是对应的 XPath 表达方式。如果页面可能追加其他类名,应避免把整个 class 属性当成固定字符串精确匹配。
需求 | CSS | XPath |
|---|---|---|
简单类名与 ID | 简洁 | 支持 |
属性匹配 | 支持 | 支持 |
祖先与兄弟节点关系 | 取决于选择器支持情况 | 适合表达树结构导航 |
入门可读性 | 通常比较直观 | 需要学习轴等语法 |
Scrapy 数据提取 | 支持 | 支持 |
选择器应来自实际响应或渲染后的 DOM。网站修改结构后,浏览器仍能正常显示,并不代表旧提取规则继续有效。保留有代表性的 HTML 样例,同时检查必填字段和预期记录数,才能及时发现变化。
清洗、去重与存储
提取只是数据处理的起点。应按照明确的数据结构规范化空白、日期、货币格式、数字字符串和库存标签。值确实不存在时保留空值,并区分“缺失”“解析错误”和真实数值零。去重应优先使用稳定商品标识或规范化记录 URL,不能假定商品标题天然唯一。
Pandas 是可选工具。如果后续分析本来就使用它,可以将同一份 results 放入 DataFrame 后导出。基础教程仅为了写 CSV,并不需要引入 Pandas。Pandas CSV API说明了是否导出索引等选项。
# Optional dependency: python -m pip install pandas
import pandas as pd

df = pd.DataFrame(results)
df.to_csv("products-pandas.csv", index=False)
df.to_json("products-pandas.json", orient="records", indent=2,
           force_ascii=False)
对于周期性抓取,可以把字段校验和重复记录处理放到 Scrapy Pipeline 或已有处理层中。需要查询、更新或事务时选择数据库;可携带的导出用 CSV 或 JSON 可能已经足够。同时记录来源 URL 与采集时间,方便后续使用者判断数值的出处和时效。
在明确范围内处理分页
网站可能使用页码、“下一页”链接、分类链接、无限滚动或 API 游标。只有真实网站确实使用某种模式时,才能拼接页码 URL;不能凭空假定存在 /products?page=2。先检查导航,确认第二页返回不同记录,再扩展循环。
下面的扩展复用 parse_products,只跟随起始源内的 HTTP(S)“下一页”链接,去掉 URL 片段,拒绝本练习范围外的重定向,记录已访问页面,并最多读取五页。当前样例没有下一页链接,所以在第一页结束。要测试第二页,可以创建包含不同 SKU 的本地 HTML 文件,并在第一页添加 <a class="next" href="products-2.html">Next</a>。
from urllib.parse import urljoin, urldefrag, urlsplit
import time

start_url = "http://127.0.0.1:8000/products.html"
origin = urlsplit(start_url)
current = start_url
visited = set()
all_results = []

while current and current not in visited and len(visited) < 5:
    visited.add(current)
    response = requests.get(current, timeout=(3, 10), allow_redirects=False)
    response.raise_for_status()
    if 300 <= response.status_code < 400:
        raise ValueError("Review this redirect before expanding crawl scope")
    all_results.extend(parse_products(response.text))
    soup = BeautifulSoup(response.text, "html.parser")
    next_link = soup.select_one("a.next[href]")
    current = None
    if next_link:
        candidate = urldefrag(urljoin(response.url, next_link["href"]))[0]
        target = urlsplit(candidate)
        if (target.scheme in {"http", "https"}
                and (target.scheme, target.netloc) == (origin.scheme, origin.netloc)
                and target.username is None and target.password is None):
            current = candidate
    if current and current not in visited and len(visited) < 5:
        time.sleep(1)  # Teaching default; use the site's actual rate policy.

print(len(all_results))
已访问集合能阻止直接的 URL 循环,但不同 URL 仍可能返回重复商品,因此记录层面需要单独去重。查询参数、排序和会话 URL 都可能扩大抓取空间;实际任务应明确允许的路径与查询参数。面对大型、持续发现链接的任务,使用 Scrapy 的调度与过滤机制通常比不断扩充这个循环更容易维护。
用 Playwright 处理 JavaScript 渲染页面
如果浏览器看得到数据,而原始响应中没有,应对比初始 HTML 与实时 DOM,并观察页面如何请求数据。有些页面必须经过浏览器渲染,有些则提供更适合使用的正式 API。常见过程是“初始 HTML → JavaScript → Fetch/XHR → 追加数据 → 渲染元素”。
只安装练习需要的浏览器即可。以下命令采用 Playwright 官方安装流程,明确选择 Chromium。
python -m pip install playwright
python -m playwright install chromium
下面的示例仍打开同一个本地样例,可直接运行,用于演示基于 Locator 的等待和资源清理;样例本身是静态页面。迁移到获得授权的动态页面时,应根据真实 DOM 修改 URL 与选择器,并在收集列表前等待明确的加载状态或预期记录数。
from playwright.sync_api import sync_playwright, expect

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    try:
        page = browser.new_page()
        response = page.goto("http://127.0.0.1:8000/products.html",
                             wait_until="domcontentloaded", timeout=15000)
        if response is None or not response.ok:
            raise RuntimeError("Page navigation failed")
        expect(page.get_by_role("heading", name="Example products",
                                exact=True)).to_be_visible()
        products = page.locator(".product")
        expect(products).to_have_count(2)  # Known fixture count, not a universal rule.
        print(products.locator(".title").all_text_contents())
    finally:
        browser.close()
Playwright 的 Locator 文档介绍了定位与等待机制。通过 Locator 点击时会等待元素可操作,但读取整个列表前仍需确认列表已经准备好。domcontentloaded 并不代表异步数据已经到达,固定休眠也不能可靠替代加载状态断言。
如果页面确实存在“加载更多”按钮,可以使用基于角色的 Locator,并等待操作后的状态。例如,只有确认按钮存在,page.get_by_role("button", name="Load more").click() 才有意义。本地样例没有这个按钮。无限滚动页面也需要停止条件,例如明确的结束标记或经过确认的最大加载批数。
网络检查可能发现结构化 JSON 响应。适合时可以使用有文档、获授权的接口,同时遵守其认证与使用要求。在浏览器流量中发现某个端点,并不意味着它没有访问限制,也不意味着内部 API 自动成为公开 API。
排查 403、429、验证码与数据缺失
更换基础设施之前,先定位失败的层次。超时、访问拒绝、选择器失效和重复记录是不同问题。状态码与响应内容可以缩小排查范围,而提取指标能够发现 HTTP 请求成功却仍然存在的数据问题。
症状 | 可能所属类别 | 首先检查 |
|---|---|---|
429 | 触发限流 | 请求压力与 Retry-After |
403 | 访问被拒绝 | 认证、响应详情和访问策略 |
验证码或挑战页 | 流量验证 | 授权访问方式与抓取行为 |
原始 HTML 中没有数据 | 渲染或响应不符合预期 | 对比 HTML、DOM 和网络数据 |
字段缺失 | 页面结构或选择器变化 | 必填字段校验和样例 |
超时 | 网络或服务器延迟 | 连接/读取超时及服务状态 |
重复记录 | 发现或处理逻辑 | 稳定标识、分页和 URL 规范化 |
HTTP 429 与 Retry-After
RFC 6585将 429 定义为限流响应。服务器可以附带 Retry-After;HTTP 语义规范允许其使用等待秒数或 HTTP 日期。应先降低请求压力并遵守服务器提示。立即重试,或为了忽略限制而切换 IP,都没有修正任务本身的请求行为。
下面的有界重试示例只处理 429,通过 Python 的 email 日期解析器支持两种头部格式。头部缺失或格式错误时,使用较短的指数退避;服务器要求等待的时间超过本地预算时,停止并抛出错误,不擅自缩短有效等待时间。其他 HTTP 错误和连接异常继续交给调用方处理。
import math
import re
import time
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime
import requests


def retry_after_seconds(value, now=None):
    if not value:
        return None
    value = value.strip()
    if re.fullmatch(r"[0-9]+", value):
        return int(value)
    try:
        deadline = parsedate_to_datetime(value)
        if deadline.tzinfo is None:
            deadline = deadline.replace(tzinfo=timezone.utc)
        now = now or datetime.now(timezone.utc)
        return max(0, math.ceil((deadline - now).total_seconds()))
    except (TypeError, ValueError, OverflowError):
        return None


def get_with_backoff(url, attempts=3, max_wait=60):
    if attempts < 1 or max_wait < 0:
        raise ValueError("Invalid retry limits")
    for attempt in range(attempts):
        response = requests.get(url, timeout=(3, 10))
        if response.status_code != 429 or attempt == attempts - 1:
            response.raise_for_status()
            return response
        delay = retry_after_seconds(response.headers.get("Retry-After"))
        delay = 2 ** attempt if delay is None else delay
        if delay > max_wait:
            response.raise_for_status()  # Stop; never retry earlier than allowed.
        time.sleep(delay)
如果此策略符合任务要求,可以用 response = get_with_backoff(url) 替换之前的 requests.get 调用,再解析 response.text。重试次数应有上限,并记录耗尽重试的情况。生产调度器可以把长时间等待改成延后任务,避免一直占用工作进程;这个教学函数遇到该情况则明确停止。
403 与访问验证挑战
HTTP 403 表示服务器理解请求但拒绝执行,并不能单凭状态码判断唯一原因。认证、策略、地域、请求配置或应用规则都可能相关。应检查响应以及网站公开说明的访问方式。反复出现验证码时,应重新核对权限、频率、会话处理和正式 API 选项,而不是把绕过验证当成解析器修复。状态定义见 RFC 9110。
什么时候需要代理基础设施
代理不是 Python 网页抓取的前提。获得授权的小型任务往往可以直接连接。只有项目确实需要指定地域、受控的出口会话、任务隔离或多个网络位置时,才需要评估路由层。流程变为“Python 客户端 → 代理 → 目标网站”,后续的解析和校验工作仍然需要完成。
代理类别 | 网络特征 | 应评估的条件 |
|---|---|---|
数据中心代理 | 数据中心托管的出口 | 吞吐、地域、访问要求和成本 |
住宅代理 | 与住宅 ISP 网络关联的出口 | 可用地域及轮换/粘性会话行为 |
静态住宅 / ISP 代理 | 稳定的 ISP 关联端点 | 所需会话时长与路由一致性 |
移动代理 | 与蜂窝网络关联的出口 | 是否确有移动网络与相应会话需求 |
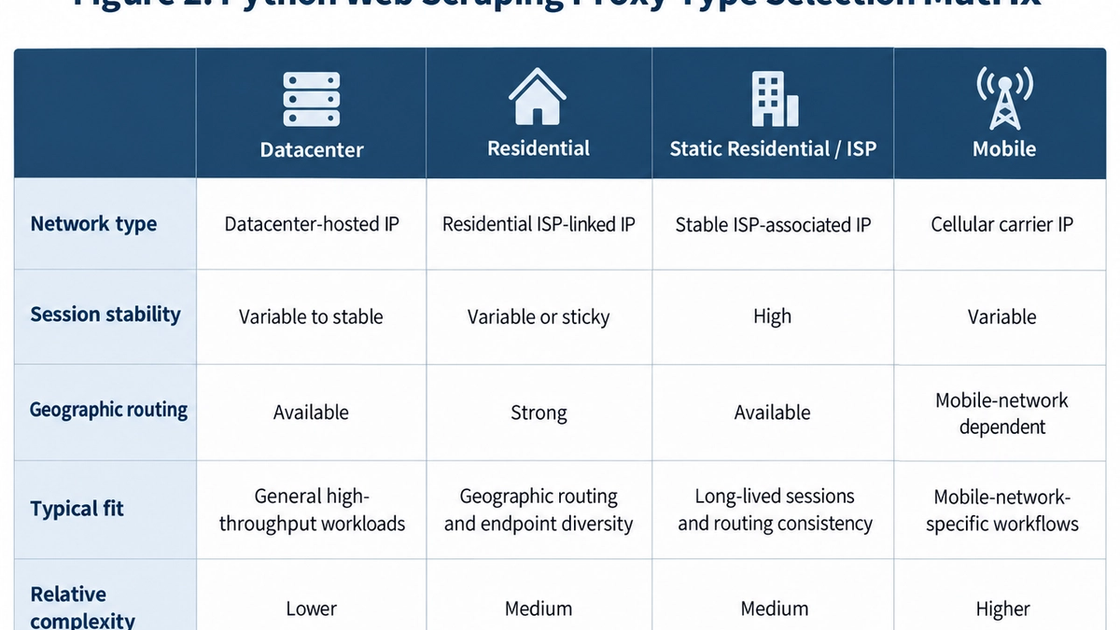
没有一种类别适合所有任务。地域、会话时长、可用出口、允许用途、吞吐和预算都会影响选型。粘性会话不代表 IP 能无限期保持不变,切换 IP 也不能修好失效的选择器,更不会带来额外访问权限。
当确实存在网络路由需求时,可以将 MiyaIP 作为路由组件进行评估。其动态住宅代理页面介绍了轮换与粘性会话以及地域定位选项。集成之前,应核对当前套餐的地域覆盖、会话限制、认证方式和允许用途条款。路由层是抓取程序的补充,不能代替请求处理、页面解析、速率控制或数据校验。
按实际网络需求评估 MiyaIP
只有在需要地域路由或出口会话管理时,再比较住宅代理方案与限制。
从单文件脚本走向可维护的数据管道
任务规模扩大后,需要明确职责:发现与调度 URL、请求或渲染页面、解析字段、清洗校验、去重、存储以及监控。可以先在现有框架或少量直接的函数中划分这些边界,再考虑增加服务。只有实际工作量或故障模式提出需求时,才新增组件。
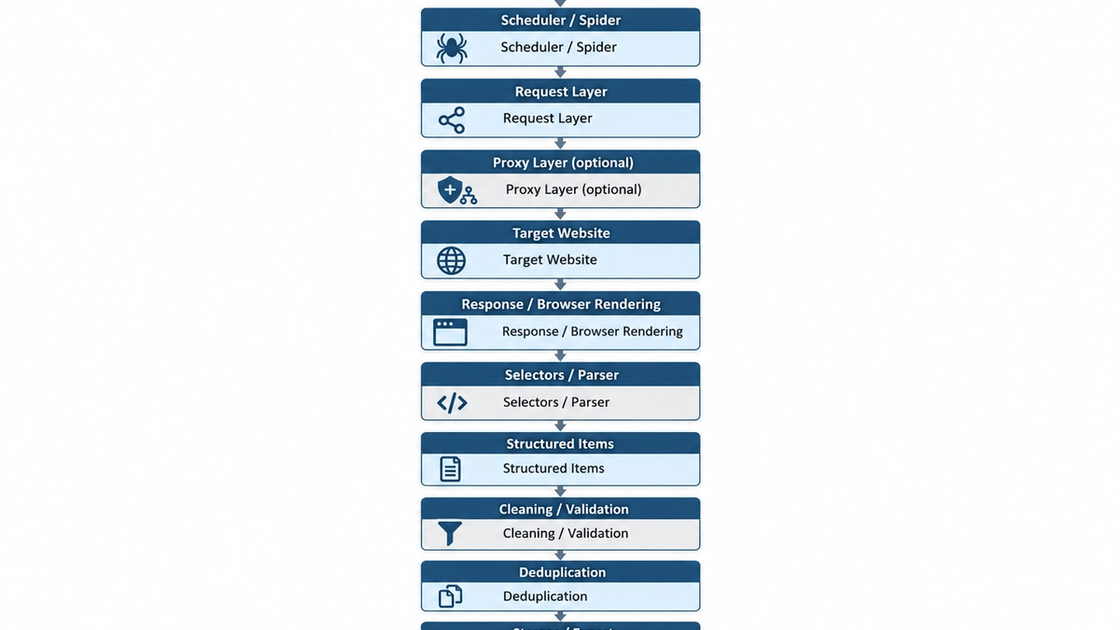
请求层负责决定抓取对象、时机和重试策略。解析层将响应转换成 SKU、标题、价格、URL、库存等字段。处理层执行规范化、校验和去重规则。存储应服务于数据使用方:文件导出、事务数据库、对象存储和内部 API 分别适合不同的后续需求。
Scrapy 的 Item Pipeline 模型可以集中处理记录,但仍需自行定义必填字段、拒绝异常数值,并确定更新与重复记录的处理方式。保留有代表性的样例,就能在不反复访问真实网站的情况下检查选择器变更。
监控请求次数、成功响应数、状态码分布、超时、重试、耗时、提取记录数、必填字段失败和重复率。进程正常退出时,也可能产出空数据或过期数据。除了程序崩溃,还应关注数据质量变化;日志中不要记录凭据、Cookie 或不必要的个人数据。
robots.txt、网站条款与负责任的数据采集
技术上能够访问,并不能单独决定是否允许采集和再利用。数据类型、认证边界、合同条款、隐私义务、司法辖区和用途都可能影响判断。商业或敏感项目应结合具体目标与用途核实,而不是依赖一个适用于所有场景的“合法或不合法”结论。
RFC 9309将 robots.txt 定义为面向爬虫的规则,并明确区分它与访问授权。禁止规则本身不是访问控制机制,没有禁止规则也不等于自动获得许可。例如:
User-agent: *
Disallow: /private-area/
实际抓取前,应检查 robots 规则与网站条款;正式 API 能满足需求时优先使用;涉及登录后数据时确认授权;只采集实现目的所需的字段,并设置合理请求限制。尊重访问拒绝与限流提示。涉及个人或敏感信息时,还应先明确存储、保留期限及删除要求。
实用的工具选择检查顺序
首先检查目标网站如何提供数据。如果 HTML 已包含所需字段,从 Requests 和 Beautiful Soup 开始;有明确解析需求时加入 lxml;链接发现、调度和重复抓取需要组织结构时使用 Scrapy;必须执行浏览器逻辑时使用 Playwright 或已有 Selenium 流程。需要分析时再加 Pandas,存在具体路由需求时再加代理。扩大规模前,先衡量数据质量和运行表现。
Python 网页抓取常见问题
Python 适合网页抓取吗?
如果它适合现有运行环境和后续流程,就很合适。Python 生态覆盖获取、解析、爬行、浏览器自动化和数据处理,具体组合应由目标页面决定。
初学者应该选择哪个库?
静态页面可以从 Requests 加 Beautiful Soup 开始,先理解获取与解析的边界。使用本地样例练习并校验必填字段,再针对获授权的真实目标调整选择器。
应该用 Beautiful Soup 还是 Scrapy?
Beautiful Soup 在程序中负责解析 HTML;Scrapy 增加了抓取调度、链接发现模式、处理扩展点和导出能力。小型解析脚本未必需要完整爬虫,而周期性多页任务通常能从框架中受益。
Selenium 和 Playwright 如何选择?
两者都能控制浏览器,应根据浏览器需求、现有基础设施与维护成本决定。Playwright 支持 Chromium、Firefox 和 WebKit,并提供同步与异步 Python API。
AI 工具能帮助编写抓取程序吗?
可以帮助解释 HTML、编写选择器草稿、审查代码和排查错误,但生成代码仍需运行验证。实际访问能力取决于运行环境、网络、凭据、权限以及可用工具。
自动化抓取会被识别吗?
可能会。请求时间模式、会话、网络特征和应用信号都可能暴露自动化行为。机制各不相同,没有任何库或代理能保证完全不可识别,也不能因此获得许可。
每个抓取程序都需要代理吗?
不需要。存在明确的地域、会话或网络隔离需求时再考虑代理;小型获授权任务通常可以直接连接。
收到 429 后应该怎么做?
先降低请求压力,遵守有效 Retry-After 秒数或日期,并设置有限重试。等待要求超过任务预算时,应停止或重新调度。
robots.txt 等于法律许可吗?
不等于。它表达爬虫规则,并不是授权机制。是否允许采集和再利用,需要结合实际访问方式、条款、数据、司法辖区及用途判断。
先完成一个可靠的请求、一组经过验证的选择器和一条符合要求的记录。是否使用浏览器,由真实的数据交付方式决定;是否增加爬虫框架和路由层,由实际规模与需求决定。这样既能保持管道易于理解,也能保留让数据可信的必要检查。
来源
以下资料于 2026 年 9 月 13 日核对。持续更新的文档可能变化,调整示例时应以所链接的资料为参考。
Microsoft Playwright:Python 安装文档
Microsoft Playwright:Locator 文档
IETF / RFC Editor:RFC 6585,附加 HTTP 状态码(2012)
IETF / RFC Editor:RFC 9110,HTTP 语义(2022)