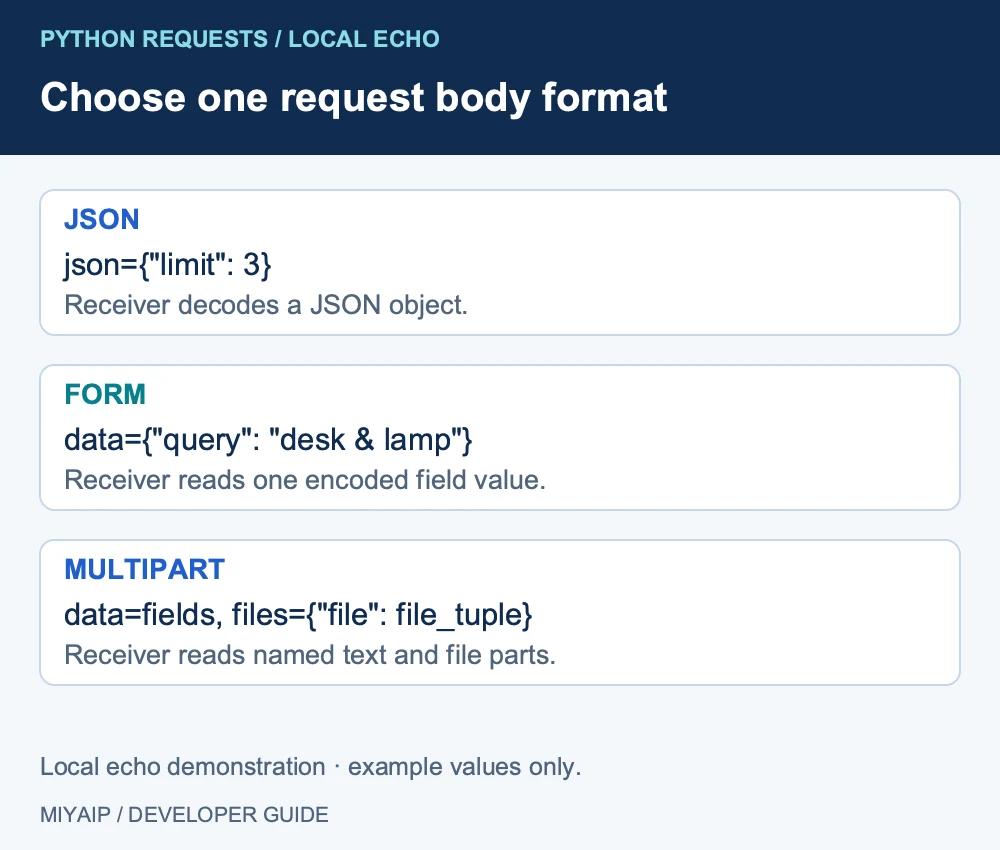
发送 Python Requests POST 时,先选择目标服务要求的请求体格式。需要将 Python 对象转为 JSON 时使用 json=,表单字段或明确的正文使用 data=,multipart 文件上传使用 files=。这些选择会影响发送的字节和 Content-Type。
本指南使用本地回显服务器,方便检查提交内容,无需将示例数据发送到外部服务。用 python3 demo_server.py 启动附带服务,再通过 python -m pip install requests 安装 Requests。
流程概览
1. 发送 JSON 对象
json=序列化对象并添加 JSON Content-Type,除非你显式覆盖。传入 Python 字典或列表,不要传入已经序列化的字符串,除非 API 明确要求一个 JSON 字符串值。2. 发送表单字段
字典会进行表单编码。回显服务将值表示为列表,以保留重复键。
desk & lamp中的 & 仍属于值,不会变为字段分隔符。3. 通过 multipart 上传文件
创建含虚构数据的小型
sample.csv,再使用:4. 使用端点文档要求的请求体格式
不要将
json=与独立的data=或files=混用,并假定全部内容会合成一个 JSON 请求。应选择一种格式;文档明确支持的表单字段与文件 multipart 组合除外。5. 分别检查请求和响应
请求的 Content-Type 描述发送内容,响应的 Content-Type 描述返回内容。只在正文不含私密数据时检查实际内容;调试时避免记录凭据或个人记录。
6. 处理错误时避免重复执行操作
超时不能证明 POST 在到达服务器之前就失败了。重试创建任务、支付等有副作用的操作前,遵循服务的幂等或查询机制。
1. 发送 JSON 对象
import requests

url = "http://127.0.0.1:8766/echo"
payload = {"category": "office", "limit": 3}
response = requests.post(url, json=payload, timeout=(3, 15))
response.raise_for_status()
print(response.json()["json"])
# {'category': 'office', 'limit': 3}
json= 序列化对象并添加 JSON Content-Type,除非你显式覆盖。传入 Python 字典或列表,不要传入已经序列化的字符串,除非 API 明确要求一个 JSON 字符串值。
仅设置 Content-Type: application/json 不会把 Python 字典变成 JSON 请求体,编码方式仍然重要。Requests 快速入门介绍了 JSON 和表单处理。
2. 发送表单字段
response = requests.post(
    "http://127.0.0.1:8766/echo",
    data={"category": "office", "query": "desk & lamp"},
    timeout=(3, 15),
)
response.raise_for_status()
print(response.json()["form"])
# {'category': ['office'], 'query': ['desk & lamp']}字典会进行表单编码。回显服务将值表示为列表,以保留重复键。desk & lamp 中的 & 仍属于值,不会变为字段分隔符。
同名字段使用元组列表,例如 [('tag', 'office'), ('tag', 'lighting')]。普通字典无法表达两个拥有相同键的独立条目。
3. 通过 multipart 上传文件
创建含虚构数据的小型 sample.csv,再使用:
from pathlib import Path
import requests

Path("sample.csv").write_text("id,name\np1,Travel Mug\n", encoding="utf-8")
with open("sample.csv", "rb") as handle:
    response = requests.post(
        "http://127.0.0.1:8766/echo",
        data={"source": "tutorial"},
        files={"file": ("sample.csv", handle, "text/csv")},
        timeout=(3, 15),
    )
response.raise_for_status()
print(response.json()["parts"])
让 Requests 构造 multipart Content-Type 和 boundary。手动只设置 multipart/form-data 可能缺少服务器解析正文所需的边界。以二进制模式打开文件,并保持句柄到请求结束。
字段名 file 仅为示例,应符合目标 API 要求的字段名、文件名约束和上传大小限制。
4. 使用端点文档要求的请求体格式
目标要求 | Requests 参数 | 常见错误 |
|---|---|---|
JSON 对象或数组 |
| 将已编码的 JSON 字符串当作对象传入 |
URL 编码表单 |
| 给表单正文添加 JSON Content-Type |
精确文本或二进制正文 |
| 假设 Requests 会推断所需内容类型 |
multipart 字段和文件 |
| 提供不完整的 multipart boundary 请求头 |
不要将 json= 与独立的 data= 或 files= 混用,并假定全部内容会合成一个 JSON 请求。应选择一种格式;文档明确支持的表单字段与文件 multipart 组合除外。
5. 分别检查请求和响应
print(response.request.method)
print(response.request.headers.get("Content-Type"))
print(response.status_code)
print(response.headers.get("Content-Type"))
请求的 Content-Type 描述发送内容,响应的 Content-Type 描述返回内容。只在正文不含私密数据时检查实际内容;调试时避免记录凭据或个人记录。
用 raise_for_status() 检查 HTTP 失败,再验证 API 自己的成功字段。有效 JSON 也可能表示业务错误;HTTP 成功也可能没有正文,不应对 204 响应无条件调用 response.json()。
6. 处理错误时避免重复执行操作
问题 | 优先检查 |
|---|---|
400 Bad Request | 必填字段、类型、正文语法和服务错误信息 |
401 或 403 | 鉴权及操作权限 |
415 Unsupported Media Type | 正文编码与 Content-Type |
JSON 解码失败 | 响应状态、类型及是否存在正文 |
提交后超时 | 服务器是否已经接受或完成操作 |
超时不能证明 POST 在到达服务器之前就失败了。重试创建任务、支付等有副作用的操作前,遵循服务的幂等或查询机制。
MIYAIP Crawler API 的 POST 会创建异步任务。保存返回的任务 ID,在运行期间查询它,不要重复提交。任务指南规定了真实请求结构与鉴权方式。
常见问题
应该使用 data=json.dumps(payload) 吗?
这样会发送明确的正文,但不会自动添加 JSON Content-Type。常规对象转 JSON 使用 json=payload;需要精确编码时,有意识地同时设置正文和请求头。
timeout=(3, 15) 会把整个任务限制为 18 秒吗?
不会。它配置连接与读取等待,不是整个任务的总时限。重定向、重试和持续传输都可能增加实际耗时。
多次 POST 使用 Session 有帮助吗?
Session 可复用连接并保留 Cookie 等状态,但不能使非幂等 POST 安全重复,也不能验证响应的业务含义。
本地回显确认请求体格式后,使用目标服务文档规定的参数。对于 MIYAIP,遵循 Crawler API 接口定义,并按 ID 获取创建的任务。