基本的 cURL GET 请求只需要 URL,例如 curl 'https://example.com/'。查询值使用 --get 配合 --data-urlencode,确保空格与保留字符仍属于预期值。随后检查状态与响应,不要将终端有输出等同于请求成功。
本指南使用报告所收查询值的本地回显端点。通过 python3 demo_server.py 启动附带服务。命令采用 Bash 语法,Windows 请使用 curl.exe 并遵循相应 Shell 的引号规则。
流程概览
1. 发送 GET 并检查查询参数
本地结果包含:
2. 为完整 URL 加引号或分别编码值
查询已经编码好的 URL,应对整个地址加引号:
3. 有意识地添加请求头与鉴权
Accept 表达客户端能处理的响应格式,不会强制端点支持该格式。遵循真实服务的鉴权说明,分享示例命令时不包含真实凭据。
4. 分离正文、请求头和状态
这会分别保存响应正文和响应头。希望将响应头与正文一起显示以便检查时使用
-i,但不要把混合输出存入应用预期只含 JSON 的文件。5. 分别处理重定向和错误
cURL 默认不跟随重定向。适合跟随时使用
--location;请求去往意外位置时检查最终 URL。6. 使用 GET 查询已有 MIYAIP 任务
MIYAIP Crawler API 通过 POST 创建任务,通过 GET 获取状态和结果。获得返回的任务 ID 后,按文档使用以下查询结构:
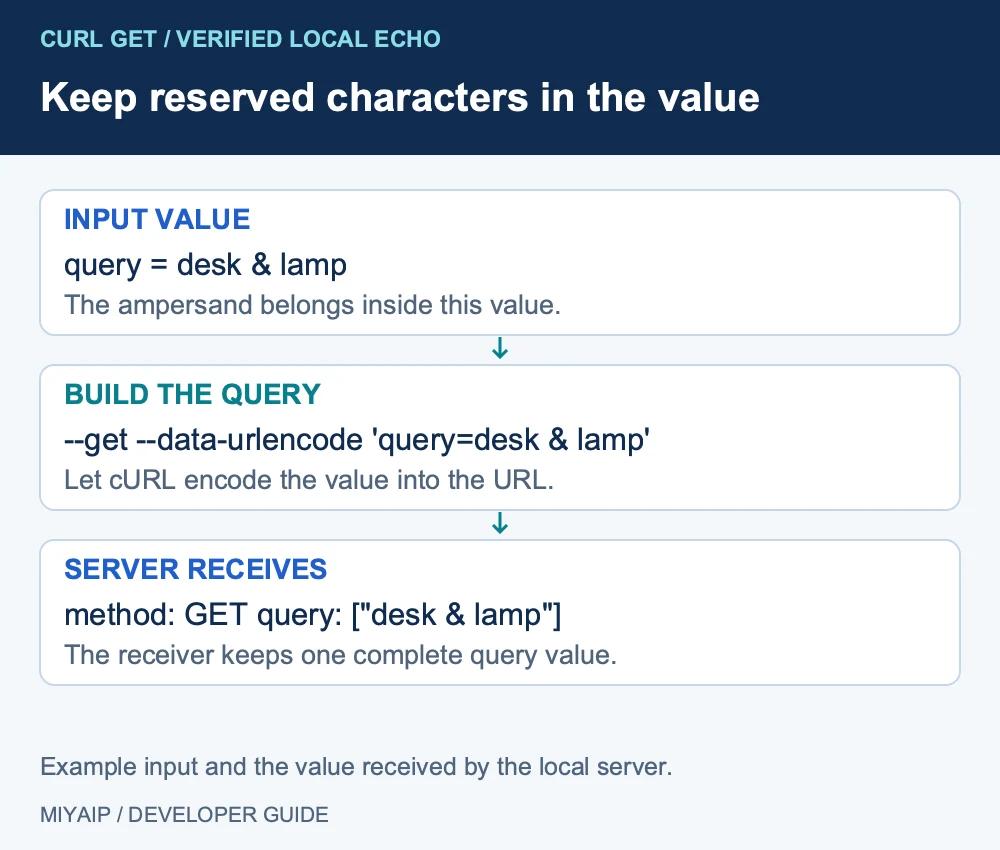
1. 发送 GET 并检查查询参数
curl --fail-with-body -sS --max-time 30 \
  --get \
  --data-urlencode 'query=desk & lamp' \
  --data-urlencode 'page=2' \
  'http://127.0.0.1:8766/echo'
本地结果包含:
{
  "method": "GET",
  "args": {
    "query": ["desk & lamp"],
    "page": ["2"]
  },
  "path": "/echo"
}
--get 告诉 cURL 将数据参数放入查询字符串。没有它时,数据选项可能选择 POST。-X GET 不能代替对参数位置的选择。
2. 为完整 URL 加引号或分别编码值
查询已经编码好的 URL,应对整个地址加引号:
curl --fail-with-body -sS --max-time 30 \
  'http://127.0.0.1:8766/echo?category=office&page=2'
Bash 中未加引号的 & 具有 Shell 含义,命令可能看似运行,却已被拆成非预期操作。
值包含空格、& 或非 ASCII 文本时,优先使用 --data-urlencode,不要手工拼接编码。参数名必须与端点文档一致;发送 page=2 不能为实际需要游标的 API 实现分页。
3. 有意识地添加请求头与鉴权
curl --fail-with-body -sS --max-time 30 \
  -H 'Accept: application/json' \
  'http://127.0.0.1:8766/echo'
Accept 表达客户端能处理的响应格式,不会强制端点支持该格式。遵循真实服务的鉴权说明,分享示例命令时不包含真实凭据。
不要为了模仿 POST 示例给 GET 添加请求体。查询参数与正文位于请求的不同部分,目标服务可能不会按预期解释 GET 正文。
4. 分离正文、请求头和状态
curl --fail-with-body -sS --max-time 30 \
  --get --data-urlencode 'query=desk & lamp' \
  --dump-header response-headers.txt \
  --output response.json \
  --write-out 'HTTP %{http_code}\n' \
  'http://127.0.0.1:8766/echo'
这会分别保存响应正文和响应头。希望将响应头与正文一起显示以便检查时使用 -i,但不要把混合输出存入应用预期只含 JSON 的文件。
-I 发出 HEAD 请求,不能保证测试了完整 GET 的相同行为;一些服务对两种方法处理不同。
cURL 手册说明了输出和方法选项。检查 HTTP 状态后,还需检查 API 的成功字段:HTTP 200 也可能包含业务错误。
5. 分别处理重定向和错误
cURL 默认不跟随重定向。适合跟随时使用 --location;请求去往意外位置时检查最终 URL。
现象 | 检查内容 | 不要假设 |
|---|---|---|
301 或 302 | Location 与预期目标 | 已经返回目标数据 |
400 | 查询名称、编码与类型 | 更换代理就能修复无效输入 |
401 或 403 | 鉴权、权限及服务响应 | 正文是完整公开结果 |
429 | 限流说明及存在时的 Retry-After | 立即重复请求有帮助 |
网络超时 | 连接与响应耗时 | 请求从未到达服务 |
定期采集应记录来源 URL、采集时间与失败情况。保存的文件既可能包含预期数据,也可能只是错误页面。
6. 使用 GET 查询已有 MIYAIP 任务
MIYAIP Crawler API 通过 POST 创建任务,通过 GET 获取状态和结果。获得返回的任务 ID 后,按文档使用以下查询结构:
curl --fail-with-body -sS --max-time 30 --get \
  -H "Authorization: Bearer $MIYA_CONSOLE_TOKEN" \
  --data-urlencode "taskId=$MIYA_TASK_ID" \
  'https://miyaip.com/api/Crawler/TaskResult'
从自己的鉴权流程设置变量。检查业务数字码和 HTTP 状态,再检查任务状态。运行期间查询同一任务,不要创建新任务。Crawler API 文档说明了鉴权、轮询和积分记录。
常见问题
必须使用 -X GET 吗?
仅包含 URL 的基本 GET 不需要。数据参数要进入查询字符串时使用 --get;只指定方法字符串不会完成转换。
为什么包含 & 的值变成了两个参数?
检查 Shell 引号与 URL 编码。完整 URL 应加引号,构造查询时用 --data-urlencode 编码各个值。
相同命令可以保存 HTML 页面吗?
可以。通过 --output 使用合适文件名,并检查返回的 Content-Type 与正文。以 .json 结尾的文件名不会将 HTML 转成 JSON。
通过一个小请求确认查询参数和响应,然后使用文档规定的任务生命周期,或将已验证的请求接入自己的应用。