页面包含所需记录或 HTML 表格时,R 适合进行网页采集。使用 httr2 发送请求、rvest 选择并解析内容,然后在导出数据框前明确校验。
本指南将虚构商品表格导出为 CSV,也说明如何处理重复卡片、缺失值和网络配置,区分数据获取与分析。
流程概览
1. 安装依赖并打开示例
在 R 中安装 httr2 和 rvest:
2. 请求页面并解析表格
保存为
products.R,在 R 会话中运行,或执行Rscript products.R:3. 分析前检查结果
预期示例记录如下:
4. 没有表格时提取重复卡片
对于卡片布局,先选择每条记录的容器,再在容器内提取对应值:
5. 排查空的提取结果
静态解析不执行 JavaScript。rvest HTML 文档区分了原始 HTML 与浏览器辅助读取。结果为空时应检查响应,而不是直接更换 IP。
6. 仅在请求需要时配置代理
httr2 支持显式代理配置。将代理主机和凭据与目标 URL 分开:
1. 安装依赖并打开示例
在 R 中安装 httr2 和 rvest:
install.packages(c("httr2", "rvest"))在另一个终端用 python3 demo_server.py 启动附带服务,再打开 http://127.0.0.1:8766/table。页面含三个虚构商品,列名为 id、name 和 price_usd。
本地页面提供稳定输入。明确解析器在数据存在、缺失或格式错误时应如何表现,再切换到真实目标。
2. 请求页面并解析表格
保存为 products.R,在 R 会话中运行,或执行 Rscript products.R:
library(httr2)
library(rvest)

response <- request("http://127.0.0.1:8766/table") |>
  req_timeout(15) |>
  req_perform()
document <- resp_body_html(response)
prices <- document |>
  html_element("table#prices") |>
  html_table(convert = FALSE)
stopifnot(identical(names(prices), c("id", "name", "price_usd")))
prices$price_usd <- as.numeric(prices$price_usd)
stopifnot(!anyNA(prices$price_usd), !anyDuplicated(prices$id))
write.csv(prices, "r-products.csv", row.names = FALSE, na = "")
print(prices)
请求使用 15 秒超时。httr2 的普通请求处理会报告 HTTP 失败;解析器选择 table#prices,而非收集页面上的全部表格。
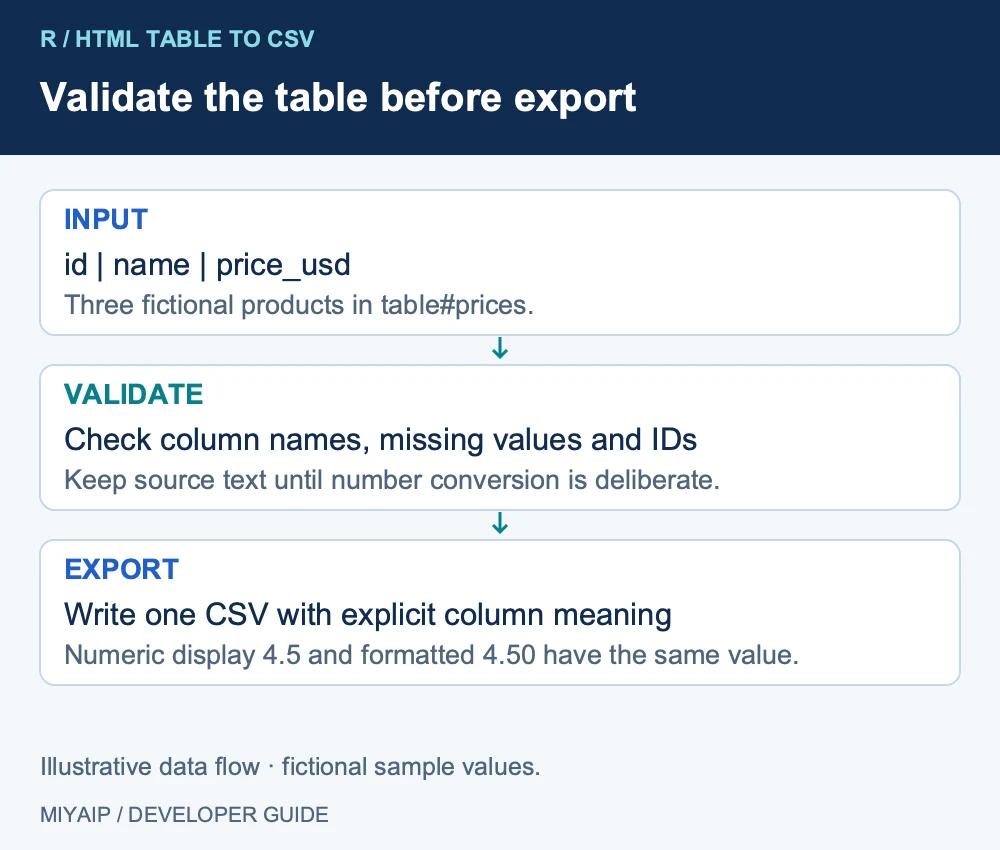
html_table(convert = FALSE) 起初保留文本单元格。脚本验证预期列名,有意识地转换价格,并在保存 CSV 前检查缺失值及重复标识符。
单个表格节点返回 tibble,多个节点返回列表。分析流程预期单个数据框时,需要注意区别。rvest 表格参考说明了合并与缺失单元格的处理。
3. 分析前检查结果
预期示例记录如下:
id | name | price_usd |
|---|---|---|
p1 | Travel Mug | 19.90 |
p2 | Desk Lamp | 32.00 |
p3 | Notebook | 4.50 |
R 可能将数值价格显示为 19.9 或 4.5,但数值未变。报告需要两位小数时再设置显示格式,计算时仍保留数值列。
真实页面可能使用货币符号、小数逗号或“联系我们”等标签。不要删除所有非数字字符后就把结果当作有效价格。应确定来源的币种与数字格式,按需要保留原值,并明确标识无法解析的数据。
4. 没有表格时提取重复卡片
对于卡片布局,先选择每条记录的容器,再在容器内提取对应值:
library(rvest)
page <- read_html("http://127.0.0.1:8766/products")
cards <- html_elements(page, "article.product")
products <- data.frame(
  id = html_attr(cards, "data-id"),
  name = html_text2(html_element(cards, "h2")),
  price_text = html_text2(html_element(cards, ".price"))
)
print(products)
此示例读取第一页并返回两个商品。要获取剩余记录,需跟随下一页链接,设置页数上限并记录已访问 URL。
独立选择全部名称与全部价格,可能在某商品缺少价格时造成列错位。在各卡片内部选择可保留记录与字段的关系。
5. 排查空的提取结果
现象 | 检查内容 | 下一步 |
|---|---|---|
未选中节点 | 实际响应 HTML 与选择器 | 修正选择器或识别意外页面 |
渲染后才显示数据 | 原始 HTML 与渲染 DOM | 选择合适的浏览器辅助方式 |
记录缺失或重复 | 容器范围与分页 | 校验标识符并跟随真实分页 |
数字转换生成 NA | 原单元格值与数字格式 | 显式处理异常值 |
静态解析不执行 JavaScript。rvest HTML 文档区分了原始 HTML 与浏览器辅助读取。结果为空时应检查响应,而不是直接更换 IP。
6. 仅在请求需要时配置代理
httr2 支持显式代理配置。将代理主机和凭据与目标 URL 分开:
library(httr2)
req <- request("https://example.com/") |>
  req_proxy(
    url = Sys.getenv("MIYA_PROXY_URL"),
    username = Sys.getenv("MIYA_PROXY_USER"),
    password = Sys.getenv("MIYA_PROXY_PASSWORD")
  ) |>
  req_timeout(15)
response <- req_perform(req)运行此可选示例前,用实际账户信息设置环境变量。httr2 代理参考定义了支持的参数;通过 MIYAIP 代理连接指南确认端点和连接模式。
常见问题
rvest 能处理所有 JavaScript 页面吗?
静态流程读取返回的 HTML。所需内容由浏览器稍后创建时,应使用适合该网站的浏览器辅助方式,并验证渲染结果。
表格为什么有 NA?
单元格可能缺失,也可能是转换无法识别其格式。替换 NA 前应检查原始值与表格结构。
可以定时运行 R 脚本吗?
可以,通过常用的任务调度器运行。保存采集时间、失败记录和行数,避免仅因文件存在就把某次运行当作完整数据集。
让 R 继续负责分析,并根据来源选择获取方式:直接读取 HTML、使用浏览器辅助,或调用受支持的托管采集接口。