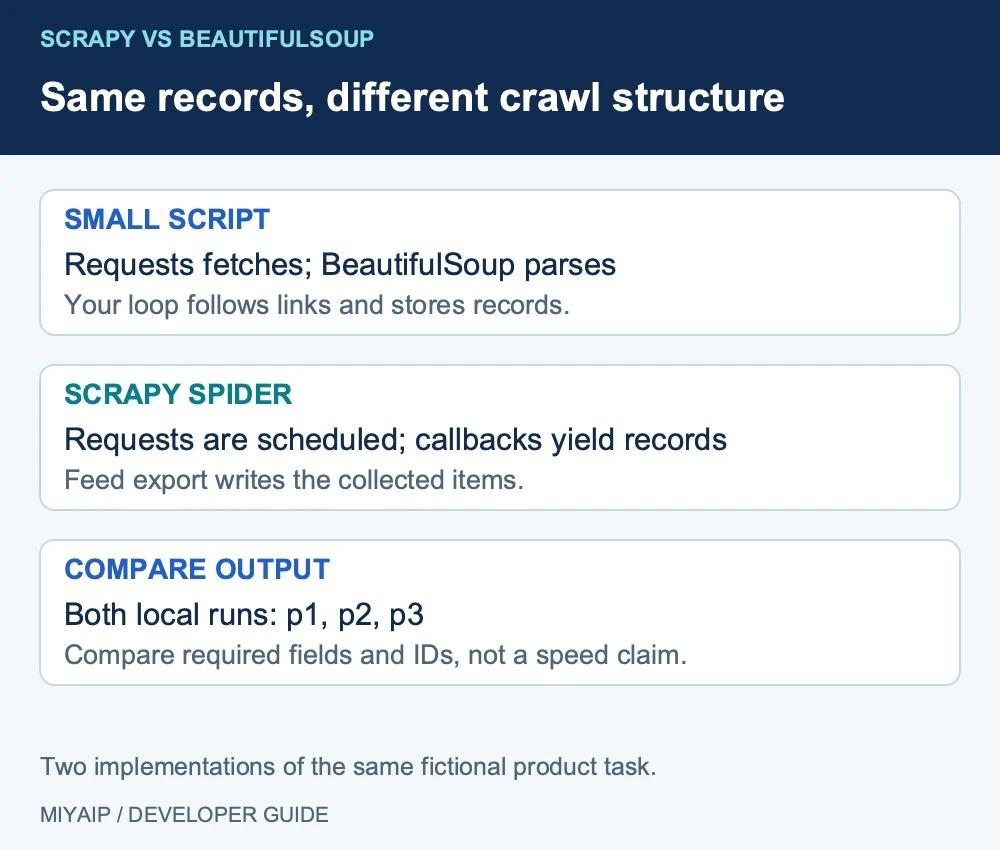
Scrapy 与 BeautifulSoup 的关键区别是工作范围。BeautifulSoup 解析你提供的 HTML;Scrapy 围绕请求、响应、链接跟踪、数据项和导出提供采集框架。它们可以组合使用,并非所有采集项目都只能二选一。
根据需要管理的工作选择,不要笼统断言哪个库更快或更好。单个已知输入用短脚本可能更好维护;当采集外围工作需要一致规则与重复运行时,框架更有价值。
比较代码前先比较职责
职责 | Requests + BeautifulSoup 脚本 | Scrapy 项目 |
|---|---|---|
获取页面 | 自己的 HTTP 客户端 | Scrapy 下载器与请求系统 |
解析 HTML | BeautifulSoup | 内置选择器或自行加入的解析器 |
继续访问其他页面 | 自己的循环或队列 | 调度请求与回调 |
跟踪重复 URL | 自己的代码 | 采集流程内的请求过滤;记录仍需验证 |
处理与导出记录 | 自己的代码 | 数据项、管道和 feed 导出 |
重复运行 | 任务调度器 | 任务调度器或 Scrapy 部署服务 |
渲染客户端 JavaScript | 独立浏览器方式 | 按需接入独立浏览器集成 |
Scrapy 教程展示请求与回调流程。无论选择哪种方式,都应先确定目标范围、所需记录与访问条件。
用 BeautifulSoup 运行相同的两页示例
通过 python3 demo_server.py 启动附带服务,它提供由下一页 URL 相连的两个虚构商品页面。安装 Requests 与 BeautifulSoup,然后保存为 bs_products.py:
import json
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup

url="http://127.0.0.1:8766/products"
rows=[]
with requests.Session() as session:
    for _ in range(5):
        response=session.get(url,timeout=(3,15)); response.raise_for_status()
        soup=BeautifulSoup(response.text,"html.parser")
        for card in soup.find_all("article",class_="product"):
            rows.append({"id":card["data-id"],"name":card.h2.get_text(strip=True),"price_usd":card.find("span",class_="price").get_text(strip=True).lstrip("$")})
        nxt=soup.find("a",rel="next")
        if nxt is None:break
        url=urljoin(url,nxt["href"])
print(json.dumps(rows,indent=2))
运行 python bs_products.py。脚本获取页面、解析每条记录并跟随下一页链接。循环上限限制示例范围,但项目扩大后,循环检测、重试规则、日志和文件管理仍由你负责。
任务较小时,这种写法易于理解,将每项职责直接展示出来,而不是隐藏在较大的项目结构中。
用 Scrapy Spider 执行相同提取
通过 python -m pip install scrapy 安装 Scrapy,将以下代码保存为 products_spider.py:
import scrapy

class ProductsSpider(scrapy.Spider):
    name="products"
    start_urls=["http://127.0.0.1:8766/products"]
    custom_settings={"DOWNLOAD_DELAY":0.2,"DEPTH_LIMIT":5,"ROBOTSTXT_OBEY":True}

    def parse(self,response):
        for card in response.css("article.product"):
            yield {"id":card.attrib["data-id"],"name":card.css("h2::text").get().strip(),"price_usd":card.css(".price::text").get().strip().lstrip("$")}
        nxt=response.css('a[rel="next"]::attr(href)').get()
        if nxt:yield response.follow(nxt,callback=self.parse)
运行:
scrapy runspider products_spider.py -O scrapy-products.json示例产出待导出的记录,通过 response.follow() 调度下一页。-O 会覆盖指定输出文件,需要保留上次结果时应换用其他文件名。
附带 Spider 启用了 robots.txt 处理。用于真实目标前,应查看目标的 robots 策略和允许的访问条件。
比较记录,不只看控制台消息
两种方式应从测试页面提取相同的 p1、p2、p3 标识符。比较必填字段与标识符,不依赖记录顺序;并发调度请求时顺序可能变化。
两种方式都将 price_usd 保留为字符串,这是示例的输出选择,不是任何一个库的限制。解析、缺失字段与币种校验仍需要明确规则。
日志显示“完成”不等于访问了所有预期页面。定期任务应保留页数、记录数、失败情况与停止原因。
何时保留小脚本
输入有限且可预测、主要工作是解析、脚本仍易于检查时,可以保留 Requests 与 BeautifulSoup。例如转换已保存的 HTML 样本、提取一个已知表格或维护有明确边界的小型报告。
不要仅为替换几行解析代码就迁移。先明确运行问题:重复 URL 处理、重试不一致、多个数据目的地,或难以追踪某条记录来自哪个请求。
何时采用 Scrapy 项目
需要可复用采集结构时值得评估 Scrapy:例如多种页面类型、大量链接、共享设置,以及一致处理记录的管道。
每次迁移一个任务。保留已知 HTML 样本、预期记录和必填字段检查,再迁移请求与解析流程,比较输出,只为明确问题加入框架能力。同时改变选择器、目标范围和并发,会增加排错难度。
主要困难是 JavaScript 渲染时,仅从 BeautifulSoup 迁移到 Scrapy 不能解决,需要受支持的浏览器集成或其他获取路径。
MIYAIP 在流程中的位置
自建脚本或 Scrapy 项目可以使用 MIYAIP 代理连接,解析与输出仍由应用控制。任务已在 Crawler API 目录中时,也可以提交托管采集任务并获取结果。
将执行方式与 HTML 解析器分开选择。自建脚本使用代理连接;受支持的托管任务使用 Crawler API 接口及其公布的参数。
常见问题
可以在 Scrapy 内使用 BeautifulSoup 吗?
可以,必要时使用其他库解析响应正文。增加依赖前,先考虑 Scrapy 已有选择器能否表达该提取任务。
Scrapy 总是更快吗?
库名不能保证普遍结论。网络延迟、并发、渲染、解析和目标限制都会影响耗时。性能重要时,应在明确条件下比较相同工作负载。
哪种更适合初学者?
小型 Requests 与 BeautifulSoup 脚本涉及较少框架概念。Scrapy 的结构有助于较大采集任务,但需要学习请求与回调模型。
小型解析器满足需求时继续使用。管理采集本身成为问题时再增加框架。希望采用受支持的托管接口时,改变应用前先检查其输入输出。