使用 JavaScript 采集网页时,先检查所需数据是否存在于 HTML 响应中。如果存在,可用 Node.js fetch() 和 Cheerio 获取并解析,无需打开浏览器。页面需要执行 JavaScript 或交互才产生数据时,再使用浏览器自动化。
本教程针对虚构的本地商品构建一个两页采集器:跟随下一页链接,写出一个 JSON 文件。本地示例有助于区分选择器问题与目标网站的网络或访问限制。
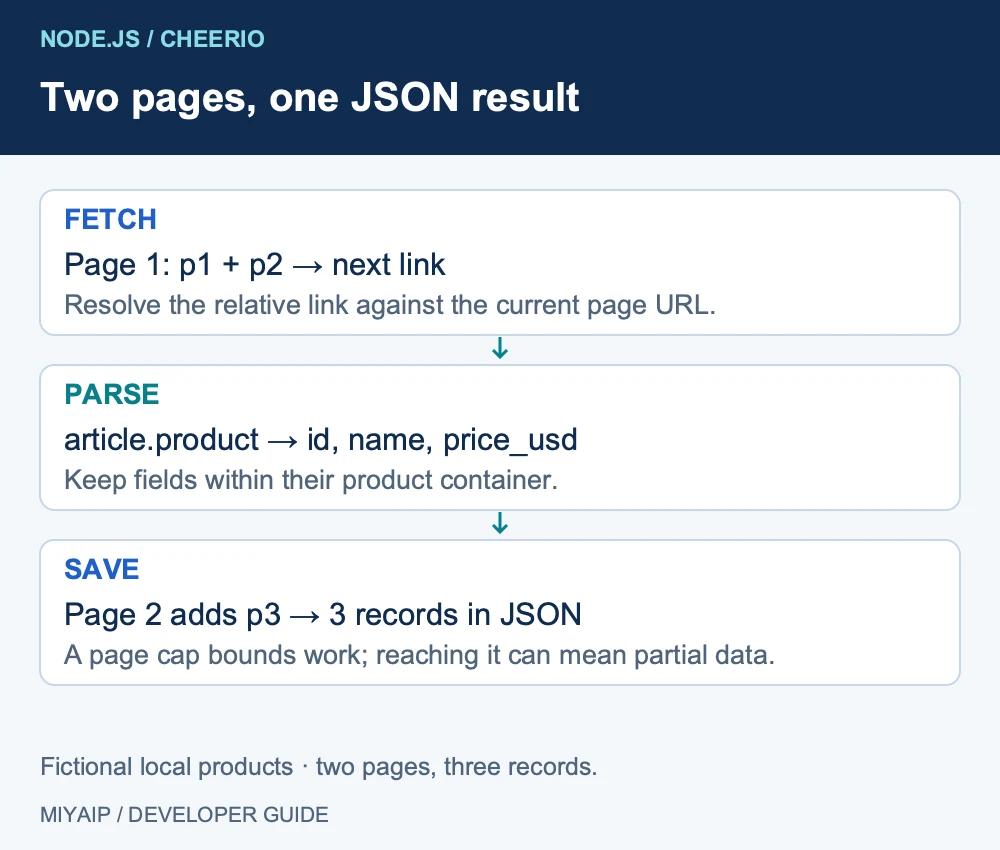
流程概览
1. 准备 Node.js 和示例站点
使用目前仍受支持的 Node.js LTS 版本。示例需要
fetch()、AbortSignal.timeout()和兼容的 Cheerio 版本。请检查已安装包的引擎要求,不要假定所有 Node.js 版本都支持这些功能。2. 获取 HTML 并通过 Cheerio 选择字段
保存为
products.mjs,然后运行node products.mjs:3. 检查 JSON 输出
本地示例在
javascript-products.json中生成三条记录:4. 翻页时保留当前 URL
下一页 URL 以刚获取的页面为基础解析。网站使用
?page=2或/products?page=2等相对链接时,这一点尤其重要。5. 判断页面是否需要浏览器
HTML 只有占位内容时,Cheerio 无法让缺失数据出现。切换工具前,比较原始响应与渲染页面。重定向、错误页和 JavaScript 空壳都可能导致商品选择器为空,但原因不同。
6. 逐项增加生产环境能力
将获取、解析和保存分为不同职责。网站标记变化后,可以重放已保存的 HTML 样本,不必每次调整解析器都重新请求网络。
1. 准备 Node.js 和示例站点
使用目前仍受支持的 Node.js LTS 版本。示例需要 fetch()、AbortSignal.timeout() 和兼容的 Cheerio 版本。请检查已安装包的引擎要求,不要假定所有 Node.js 版本都支持这些功能。
在新目录中安装 Cheerio:
npm init -y
npm install cheerio
示例文件包含 demo_server.py,请在单独的终端启动:
python3 demo_server.py打开 http://127.0.0.1:8766/products。第一页包含 Travel Mug、Desk Lamp 和下一页链接,第二页包含 Notebook。这些记录均为虚构的教程数据。
每个商品使用带有 data-id、h2 和 .price 的 article.product 容器。选择选择器前先检查响应 HTML;浏览器开发者工具显示的 DOM 可能已被脚本修改,与原始响应不同。
2. 获取 HTML 并通过 Cheerio 选择字段
保存为 products.mjs,然后运行 node products.mjs:
import * as cheerio from 'cheerio';
import { writeFile } from 'node:fs/promises';

let url='http://127.0.0.1:8766/products';
const rows=[]; const seen=new Set();
for(let page=0;url && page<5;page++){
  if(seen.has(url)) throw new Error('Repeated pagination URL');
  seen.add(url);
  const response=await fetch(url,{signal:AbortSignal.timeout(15000)});
  if(!response.ok) throw new Error(`HTTP ${response.status}`);
  const $=cheerio.load(await response.text());
  $('article.product').each((_,card)=>{
    rows.push({id:$(card).attr('data-id'),name:$(card).find('h2').text().trim(),price_usd:$(card).find('.price').text().trim().replace(/^\$/,'')});
  });
  const next=$('a[rel="next"]').attr('href');
  url=next ? new URL(next,url).href : null;
}
await writeFile('javascript-products.json',JSON.stringify(rows,null,2)+'\n');
console.log(JSON.stringify(rows,null,2));
脚本在解析前检查 response.ok。服务器返回 404 等 HTTP 错误时,fetch() 不会仅因此抛出异常。每次获取应用 15 秒中止信号,最多采集五页。
Cheerio 读取并查询返回的 HTML,不执行目标页面的 JavaScript。其加载文档说明了这里使用的 HTML 解析入口。
3. 检查 JSON 输出
本地示例在 javascript-products.json 中生成三条记录:
[
  {"id":"p1","name":"Travel Mug","price_usd":"19.90"},
  {"id":"p2","name":"Desk Lamp","price_usd":"32.00"},
  {"id":"p3","name":"Notebook","price_usd":"4.50"}
]
示例将价格保留为字符串,以保存页面显示的小数形式。在分析层有意识地转换价格,并保留货币信息。避免混用币种,也不要把缺失价格当作零。
验证数量及必填字段,标记缺少标识符或名称的记录,并在最终导出前确定重复数据处理方式。
4. 翻页时保留当前 URL
下一页 URL 以刚获取的页面为基础解析。网站使用 ?page=2 或 /products?page=2 等相对链接时,这一点尤其重要。
seen 集合阻止重复分页 URL,页数上限约束示例的运行范围。两者目的不同:前者检测循环,后者限制工作量。达到上限时若仍有下一页链接,说明采集提前停止,并不能证明已收集所有记录。
部分站点通过游标或 JSON API 分页,而非普通链接。请查看该接口的响应与文档;猜测修改 page=2 可能导致重复结果或遗漏数据。
5. 判断页面是否需要浏览器
观察到的情况 | 起始方式 | 需要验证 |
|---|---|---|
所需字段在响应 HTML 中 | Fetch 与 Cheerio | 容器选择器、编码及缺失字段 |
数据由文档化的 JSON 端点提供 | 向该端点发送 HTTP 请求 | 参数、鉴权与响应结构 |
点击或 JavaScript 渲染后才生成内容 | 浏览器自动化 | 有意义的加载完成条件及最终元素 |
HTML 只有占位内容时,Cheerio 无法让缺失数据出现。切换工具前,比较原始响应与渲染页面。重定向、错误页和 JavaScript 空壳都可能导致商品选择器为空,但原因不同。
对于已有浏览器自动化项目,使用团队能够维护的客户端,并等待真正需要的状态。Playwright 与 Puppeteer 对比可帮助选择。
6. 逐项增加生产环境能力
将获取、解析和保存分为不同职责。网站标记变化后,可以重放已保存的 HTML 样本,不必每次调整解析器都重新请求网络。
记录来源 URL 和采集时间,遵守目标服务允许的访问条件与速率限制。遇到 429 时按服务说明重试;立即反复请求可能延长临时故障。
通过 MIYAIP 运行自己的采集器时,选择合适的代理套餐,并使用 HTTP 客户端文档支持的代理配置。代理改变网络路径,不会补充缺失的渲染,也不会修复错误选择器。需要托管采集任务时,可比较 Crawler API 工作流。
常见问题
JavaScript 可以不使用 Puppeteer 或 Playwright 采集网页吗?
可以,前提是所需数据存在于 HTTP 响应中。Fetch 获取响应,Cheerio 解析 HTML。浏览器自动化适用于依赖交互等不同任务。
为什么 fetch 请求成功,却没有商品?
检查响应状态、最终 URL 和实际 HTML,再针对该 HTML 检查选择器。HTTP 200 仍可能返回登录页或非预期响应。
应该立即增加并发吗?
先验证一次请求和一次完整提取。了解目标限制、分页与输出校验后,再加入有上限的并发。
需要自定义解析时继续由 Node.js 控制流程;希望提交任务、稍后处理结果时,使用受支持的 Crawler API 接口。