
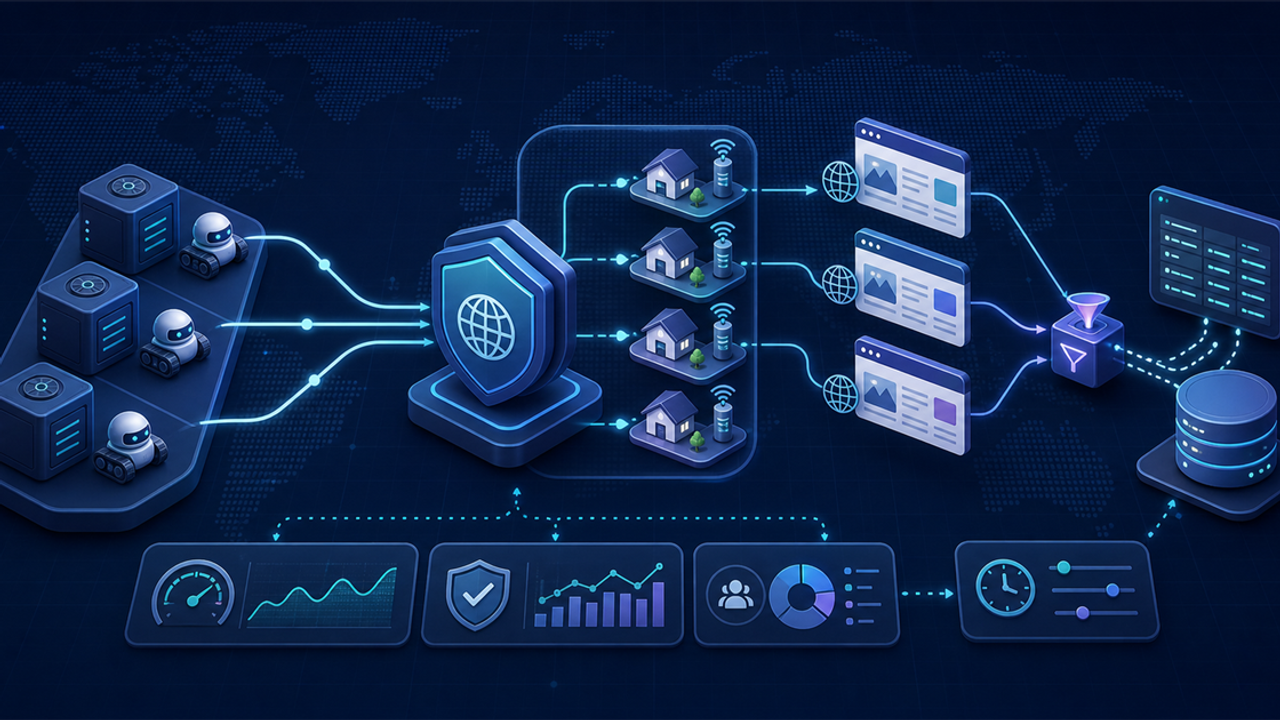
这份网页抓取代理教程将一个获准的公开网页任务依次完成代理选择、环境配置、采集、解析、JSON 与 CSV 导出及故障排查。只对明确获授权的目标使用,遵守对方公布的请求限制,并在运行前替换示例目标和联系地址。
1. 选择代理策略
工作负载 | 起始策略 | 原因 |
|---|---|---|
稳定且允许采集的公开端点 | 数据中心代理或一个静态端点 | 简单路径更容易监控和核算成本 |
跨地区的独立获准页面 | 明确地区的轮换住宅代理 | 每个页面可使用所需地区语境,且不共享会话状态 |
Cookie 绑定的多步骤流程 | 粘性住宅会话或静态住宅 IP | 在获准流程内使网络身份与 Cookie 保持一致 |
对运营商敏感的自有体验 | 移动代理 | 只有测试问题依赖蜂窝运营商路径时才使用 |
从能够提供必要地区和会话行为的最简单路径开始。增加 IP 不能替代授权、限速、可靠选择器或记录校验。
2. 配置本地 Python 项目
创建隔离环境,并安装示例唯一使用的外部包:
python -m venv .venv
# macOS 或 Linux:. .venv/bin/activate
# Windows PowerShell:.\.venv\Scripts\Activate.ps1
python -m pip install requests
把完整代理 URL 放入进程环境变量。用户名或密码中的特殊字符必须进行百分号编码。不要把真实值写入脚本、他人可见的终端历史、截图或日志。
# 使用获批准的密钥管理工具把 SCRAPING_PROXY_URL 注入当前进程。
# 在不打印值的情况下确认变量存在:
python -c "import os; assert os.environ.get('SCRAPING_PROXY_URL')"
3. 采集、解析并保存页面
将以下代码保存为 scrape.py。它复用一个 Session,设置连接与读取超时;代理认证失败时立即停止;支持整数或 HTTP 日期格式的 Retry-After;最多尝试三次;使用 Python 标准库解析首个 title 和 H1,并同时导出 JSON 与 CSV。
import csv
import json
import os
import time
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime
from html.parser import HTMLParser
from pathlib import Path

import requests

URLS = ["https://example.com/"]  # Replace with pages you are authorized to collect.
MAX_ATTEMPTS = 3
TIMEOUT = (10, 30)


class PageParser(HTMLParser):
    def __init__(self):
        super().__init__()
        self.capture = None
        self.parts = []
        self.title = ""
        self.h1 = ""

    def handle_starttag(self, tag, attrs):
        if not self.capture and tag in ("title", "h1"):
            if tag == "title" and self.title:
                return
            if tag == "h1" and self.h1:
                return
            self.capture = tag
            self.parts = []

    def handle_data(self, data):
        if self.capture:
            self.parts.append(data)

    def handle_endtag(self, tag):
        if tag != self.capture:
            return
        value = " ".join("".join(self.parts).split())
        setattr(self, tag, value)
        self.capture = None
        self.parts = []


def retry_delay(value, fallback):
    if not value:
        return fallback
    if value.isdigit():
        return min(int(value), 60)
    try:
        retry_at = parsedate_to_datetime(value)
        if retry_at.tzinfo is None:
            retry_at = retry_at.replace(tzinfo=timezone.utc)
        now = datetime.now(retry_at.tzinfo)
        return min(max(int((retry_at - now).total_seconds()), 0), 60)
    except (TypeError, ValueError, OverflowError):
        return fallback


def fetch(session, url, proxies):
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            response = session.get(url, proxies=proxies, timeout=TIMEOUT)
        except requests.Timeout:
            if attempt == MAX_ATTEMPTS:
                raise
            delay = 2 ** (attempt - 1)
            print("attempt={} timeout retry_in={}s".format(attempt, delay))
            time.sleep(delay)
            continue
        except requests.ProxyError as error:
            raise RuntimeError(
                "Proxy connection or authentication failed; check protocol, host, port, and credentials."
            ) from error

        if response.status_code == 407:
            raise RuntimeError("Proxy authentication failed (407); do not retry unchanged credentials.")
        if response.status_code == 429:
            if attempt == MAX_ATTEMPTS:
                response.raise_for_status()
            delay = retry_delay(response.headers.get("Retry-After"), 2 ** (attempt - 1))
            print("attempt={} status=429 retry_in={}s".format(attempt, delay))
            time.sleep(delay)
            continue

        response.raise_for_status()
        print("attempt={} status={} url={}".format(attempt, response.status_code, url))
        return response

    raise RuntimeError("Maximum attempts reached")


def parse(response, url):
    parser = PageParser()
    parser.feed(response.text)
    return {"url": url, "title": parser.title, "h1": parser.h1}


def save(records):
    output = Path("output")
    output.mkdir(exist_ok=True)
    (output / "results.json").write_text(
        json.dumps(records, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    with (output / "results.csv").open("w", newline="", encoding="utf-8-sig") as file:
        writer = csv.DictWriter(file, fieldnames=["url", "title", "h1"])
        writer.writeheader()
        writer.writerows(records)


def main():
    proxy_url = os.environ.get("SCRAPING_PROXY_URL")
    if not proxy_url:
        raise SystemExit("Set SCRAPING_PROXY_URL in the environment; do not put credentials in code.")

    session = requests.Session()
    session.headers["User-Agent"] = "AuthorizedResearchBot/1.0 (+contact@example.com)"

    proxies = {"http": proxy_url, "https": proxy_url}
    records = [parse(fetch(session, url, proxies), url) for url in URLS]
    save(records)
    print("saved=output/results.json,output/results.csv records={}".format(len(records)))


if __name__ == "__main__":
    main()
4. 运行 Python 示例并检查文件
python scrape.py
python --version
python -m pip show requestsPython 实测输出(已脱敏)
tested_at=2026-09-05T08:54:04Z
runtime=Python 3.12.14 requests 2.31.0
attempt=1 status=200 url=https://example.com/
saved=output/results.json,output/results.csv records=1
实测 output/results.json
[
  {
    "url": "https://example.com/",
    "title": "Example Domain",
    "h1": "Example Domain"
  }
]
CSV 包含相同的 url、title 和 h1 字段。HTTP 200 只能说明传输成功,每条记录仍必须在接收前检查必填字段。
5. 使用 HttpProxyMiddleware 配置 Scrapy
安装 Scrapy,沿用同一个 SCRAPING_PROXY_URL 环境变量,并显式启用官方 HttpProxyMiddleware。以下限速值只是保守起点;目标发布更严格规则或开始返回错误时,应继续降低速率。
python -m pip install scrapysettings.py
HTTPPROXY_ENABLED = True
DOWNLOADER_MIDDLEWARES = {
    "scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware": 750,
}

ROBOTSTXT_OBEY = True
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2.0
AUTOTHROTTLE_MAX_DELAY = 60.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 1.0
CONCURRENT_REQUESTS_PER_DOMAIN = 2
DOWNLOAD_DELAY = 1.0

RETRY_ENABLED = True
RETRY_TIMES = 2
# Keep 429 out of immediate retries; the spider stops and reports Retry-After.
RETRY_HTTP_CODES = [408, 500, 502, 503, 504, 522, 524]
spiders/example_spider.py
import os

import scrapy
from scrapy.exceptions import CloseSpider


class ExampleSpider(scrapy.Spider):
    name = "authorized_example"
    handle_httpstatus_list = [407, 429]

    async def start(self):
        proxy_url = os.environ.get("SCRAPING_PROXY_URL")
        if not proxy_url:
            raise CloseSpider("SCRAPING_PROXY_URL is not set")
        yield scrapy.Request(
            "https://example.com/",
            meta={"proxy": proxy_url},
            callback=self.parse,
        )

    def parse(self, response):
        if response.status == 407:
            raise CloseSpider("proxy_authentication_failed")
        if response.status == 429:
            wait = response.headers.get(b"Retry-After", b"not provided").decode()
            self.logger.warning("Rate limited; Retry-After=%s. Reschedule after that delay.", wait)
            raise CloseSpider("rate_limited")
        yield {
            "url": response.url,
            "title": response.css("title::text").get(default="").strip(),
            "h1": response.css("h1::text").get(default="").strip(),
        }
scrapy crawl authorized_example -O output/scrapy-results.jsonScrapy 实测输出(已脱敏)
runtime=Scrapy 2.18.0
finish_reason=finished
item_scraped_count=1
record url=https://example.com/ title="Example Domain" h1="Example Domain"
这个 Spider 使用 Scrapy 2.18.0 当前的异步 start() 接口。同一项获授权检查导出 1 条 example.com 记录,title 和 H1 均为 Example Domain。代理域名、IP、连接格式和凭据均已省略。这条结果只验证请求和导出路径,不是吞吐量、延迟或成功率基准。
这个 Spider 遇到 407 会停止,遇到 429 会记录 Retry-After,供外部调度器在指定时间后恢复。它不会通过立即轮换代理来规避限速。
6. 将教程接入生产架构
可落地的抓取代理架构
将系统拆分为已批准的任务队列、策略与限速层、感知会话的代理控制器、有限重试的请求器、记录校验器和可观测性。这样可以区分连接失败、限速、登录墙、解析失败和地域错误,而不是把所有问题都标记为代理质量差。
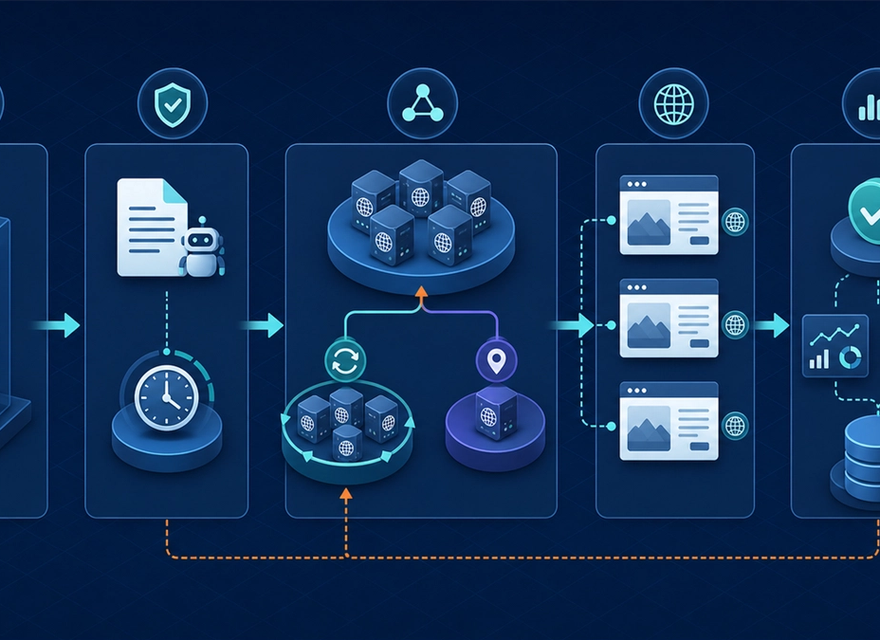
单文件示例覆盖请求路径。生产任务还应包含经过审批的队列、针对目标的规则与限速、明确的会话所有权、记录校验、解析失败隔离,以及永不记录代理凭据的日志。
7. 排查常见故障
现象 | 常见原因 | 具体检查 | 处理方式 |
|---|---|---|---|
HTTP 407 | 代理拒绝认证 | 检查代理协议、主机、端口、用户名格式、百分号编码、账户状态和 IP 白名单 | 修正凭据或访问规则;不要用相同参数重复请求 |
HTTP 429 | 目标要求降低请求频率 | 读取 Retry-After,核对当前并发、下载间隔和每域名请求数 | 按要求暂停,降低并发,并保持有限重试 |
连接或读取超时 | 网关、DNS、路由、目标或超时配置问题 | 测试网关连通性,确认目标获准,比较直连与代理 DNS 行为,并区分连接和读取耗时 | 最多按配置尝试三次,之后记录并上报路由故障 |
HTTP 200 但字段为空 | 解析器失效或页面版本变化 | 保存获准的诊断副本,检查内容类型、最终 URL、语言、title 和 H1 | 隔离记录,更新解析器后再接收数据 |
8. 扩容前验证
- 将 example.com 和联系地址替换为获授权的目标与运营联系人。
- 先运行一次请求,另外验证实际出口地区,并保存已脱敏且带时间的控制台结果。
- 打开两个输出文件,确认结构、编码、字段完整度和重复记录处理。
- 在不暴露凭据、不对第三方造成负载的条件下,分别测试受控的 407、429 和超时路径。
- 只有有效记录率、延迟、目标响应和成本都保持在获批限制内时,才提高并发。
常见问题
轮换代理能让网页抓取自动变稳定吗?
不能。轮换只解决网络路径多样性,不能解决权限、速率限制、Cookie、JavaScript 渲染、解析器变化、重复数据或错误重试逻辑。
什么时候应该使用粘性或静态代理?
当多个已获授权的请求必须保持同一网络身份时,可以使用粘性会话或静态住宅 IP。不需要连续性的独立任务才适合在任务之间轮换。
爬虫应该遵守 robots.txt 吗?
RFC 9309 将 Robots Exclusion Protocol 标准化,用于让服务所有者控制爬虫访问。它本身不是访问授权,因此团队还必须评估网站条款、合同、API 和适用法律。
收到 HTTP 429 后应该怎么办?
降低请求频率,并在提供 Retry-After 时按要求等待。在负载不变的情况下不断更换 IP,不能替代负责任的退避。
构建可控的代理层
从一个已获授权的目标、小型任务队列、明确的限速和一个可观测代理策略开始。只有数据质量和目标影响保持可接受时,才逐步扩容。